8月14日,通义千问开源 Qwen3.8-27B——270亿参数,量化后可在消费级显卡上本地部署。同期发布的云侠AI V2.5与其深度融合,搭建面向电子数据取证场景的全离线本地推理底座,持续践行“AI大模型+传统取证、逆向工具深度融合” 的技术路线,提供完备的离线取证能力支撑。
云侠AI联合飞鹰小队自去年6月至今,已持续支撑一线队伍参与50+场各类电子数据取证比武。实战成效,数据说话(仅部分参赛成绩)。
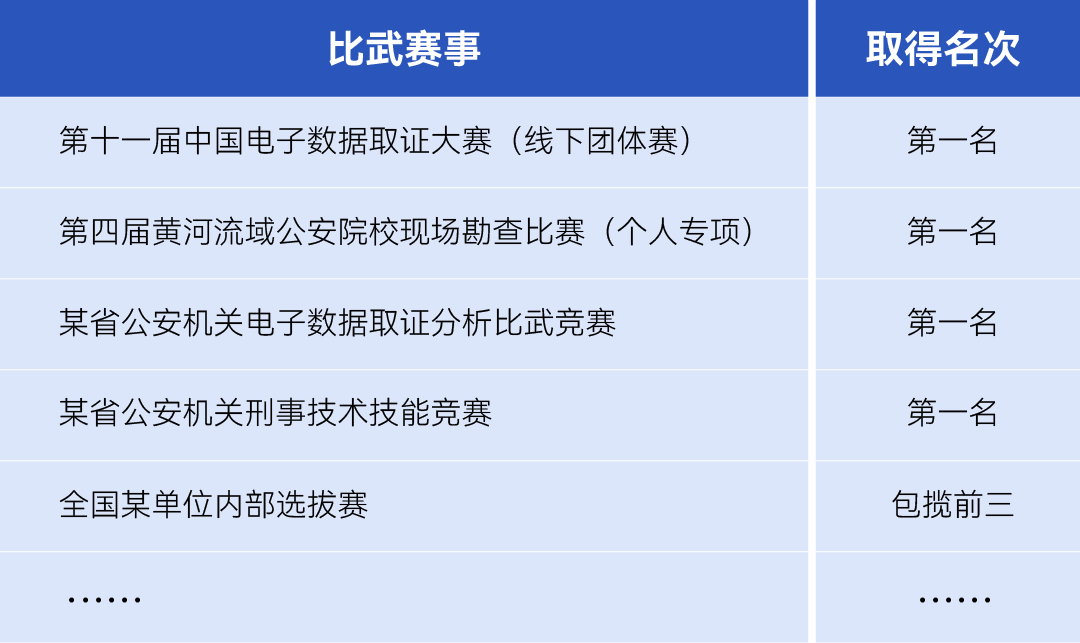
一年实战积累,50+场硬仗——云侠的能力不是实验室跑分,而是赛场实战磨出来的。
实战,是能力最好的校准场。一年50+场比武沉淀的真实需求,2.5版本将其一线经验,转化为三项可交付、可复用的核心能力:
脱壳能力全面升级,显著提升加壳样本的解析完整度与研判效率:解析更稳定、判定更准确,适配各类安卓取证场景。
EXE 动态调试能力全新上线,补齐Windows取证的动态分析闭环:运行行为可追溯、研判更精准,适配各类终端取证场景。
深度适配雷电14模拟器,化解其与本地分析环境的兼容冲突:运行稳定、切换流畅,同时适配便携算力设备,实现全场景灵活应用。
此外,推理展示、专家协作、结果导出、网络环境自检、WSL兼容等体验也在本版本同步优化。
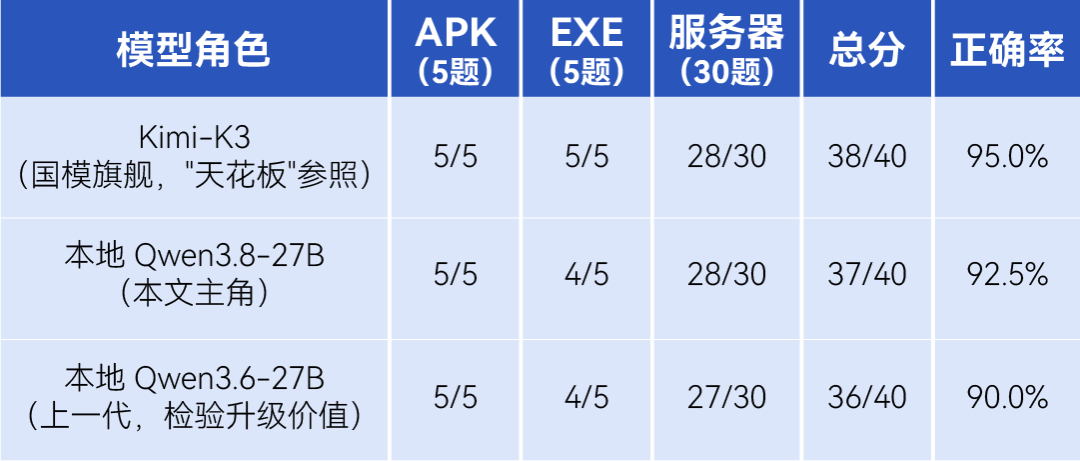
直接上赛题,用结果说话:一台RTX5090笔记本+云侠AI V2.5+本地Qwen3.8-27B(Q4量化),实测比武取证真题,40题正确率达92.5%,与最强云端旗舰仅差1道题。
赛题 第四届黄河流域公安院校现场勘查比赛,APK逆向5题、EXE PE分析5题、服务器综合取证30题,共40题;
平台 RTX5090笔记本(24GB显存+64GB内存)+ 云侠AI V2.5;本地模型采用Qwen3.8-27B(Q4 量化16.8GB),推理框架为llama.cpp;
规则 三组测试采用完全一致的原始题目设问,所有题型一次性全部提交,不对提示词做任何额外美化;所有答案均由云侠AI自主调用IDA、SSH等MCP/Skill工具实际执行得出,不接受模型"凭空作答";最终对照标准答案逐题核对得分
比武竞赛核心就是答题准确率,以各模块答对题数计算整体正确率,作为模型答题精度的评价指标。
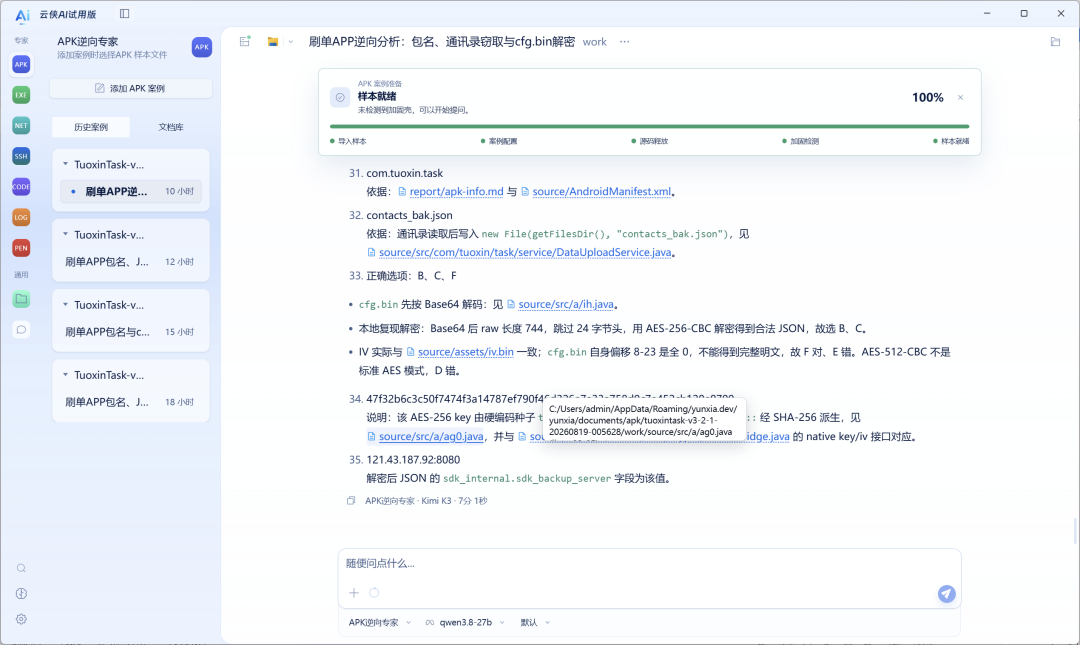
实测竞赛真题·APK题目
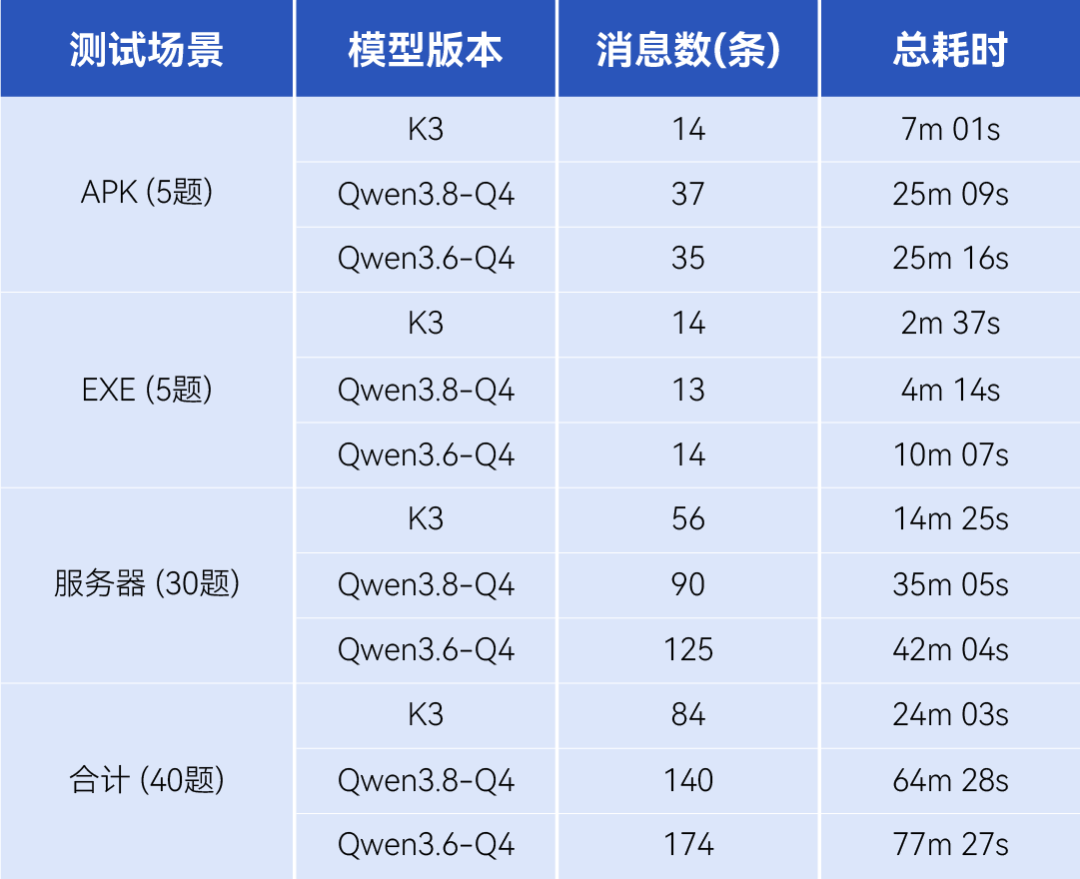
实战拼的不只是"对不对",还有"快不快"。以过程消息数(思维链 + 工具调用的总步数)作为效率指标:
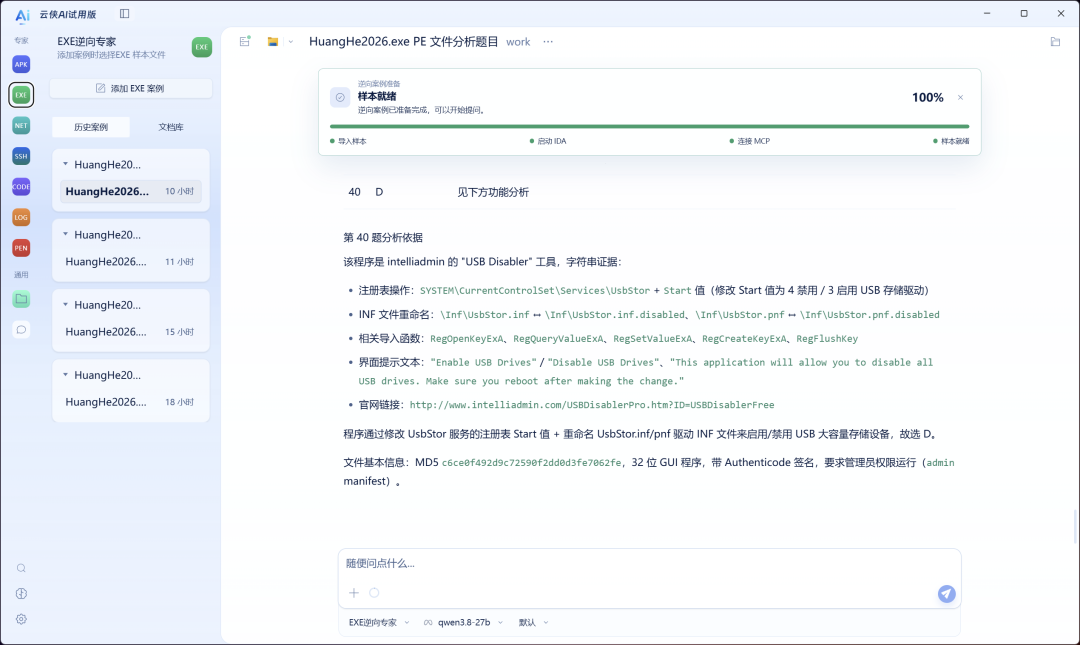
实测竞赛真题·EXE题目
实测表明,"模型+工作流"的工程化水平已取代单一模型能力,成为取证智能化的胜负手。
精度上 APK逆向三模型满分、服务器取证93.3%与云端旗舰持平,核心场景具备平替能力;EXE场景失分仅在核验环节,可经流程优化弥补。
效率上 Qwen3.8将消息总数从174条压至140条,推理冗余快速收敛,配合提示词约束仍有优化空间。
价值上 以云侠AI为工作流引擎、Qwen3.8-27B为本地底座的方案,已非云端的"低配替代",而是电子数据取证走向现场作业与合规落地的成熟路径。
实测竞赛真题·服务器
取证逆向行业经验的长期积累,叠加一年50+场比武磨出的实战底气。从加壳样本到动态闭环,从APK研判到赛场实测,2.5版本把"本地大模型"真正变成了"赛场即现场"——拥抱AI,重塑取证,为实战而生。
附录 · 测试环境
机型:ROG Strix SCAR18 G835LX RTX5090 Laptop(24GB显存)+ 64GBDDR5 + Ultra9 275HX,Windows11;模型:Qwen3.8-27B / Qwen3.6-27B(Q4,GGUF);云端对照:Kimi-K3;分析平台:云侠AI V2.5;推理框架:llama.cpp。所有成绩均以标准答案逐题核对为准,过程数据取自3个模型×3 类场景共9份完整对话导出。
后台回复【云侠AI】可获取完整《三模型多场景对比分析报告》