今天跟大家一起看一下 GPT-6 Sol 的情况。GPT-6 Sol 跟 Claude Opus 5.5 基本上是同一天发布的,但口碑其实已经呈现出了非常明显的两极分化。
GPT-6 Sol 的价格要比 5.6 Sol 更便宜 10 美元/Million 的输出,5.6 Sol 促销价的一半左右。
OpenAI 方面表示,这个模型采用了类似 Astra 的方法,能够完成很多专业工作、写代码以及操作电脑等任务,而且整个输出更短、废话更少;但是从大家实际使用的体感来看,整个模型的质量其实是大幅下降的,现在唯一能够夸的,就是更加耐用了,
我相信大家其实也发现了,这一次 OpenAI 整个宣传的核心点,就是反复强调这个模型更便宜。这跟以前新模型发布的宣传套路完全不一样。以前都是告诉你:更聪明、更强、更快;这一次上来先告诉你:兄弟,我便宜啊,香不香。
这不,所有的自媒体都高潮了...
狂降 80% GPT-6-Sol 上线杀疯了!还有不要钱的Luna
杀疯,那要被我封杀了。
那这种变化肯定是有内在原因的。目前总结下来,我觉得最主要的原因就是,这个模型整体智能水平确实不够。也许它在一些非编码任务上表现还不错,但是在编码任务上,肯定是明显倒退的。
最近有很多朋友都在测试新模型的表现,CodeReader (http://codexradar.com/) 也在做更多测试,目前已经有一些结果了,不过数据还不算特别多,大家有空可以继续关注一下。
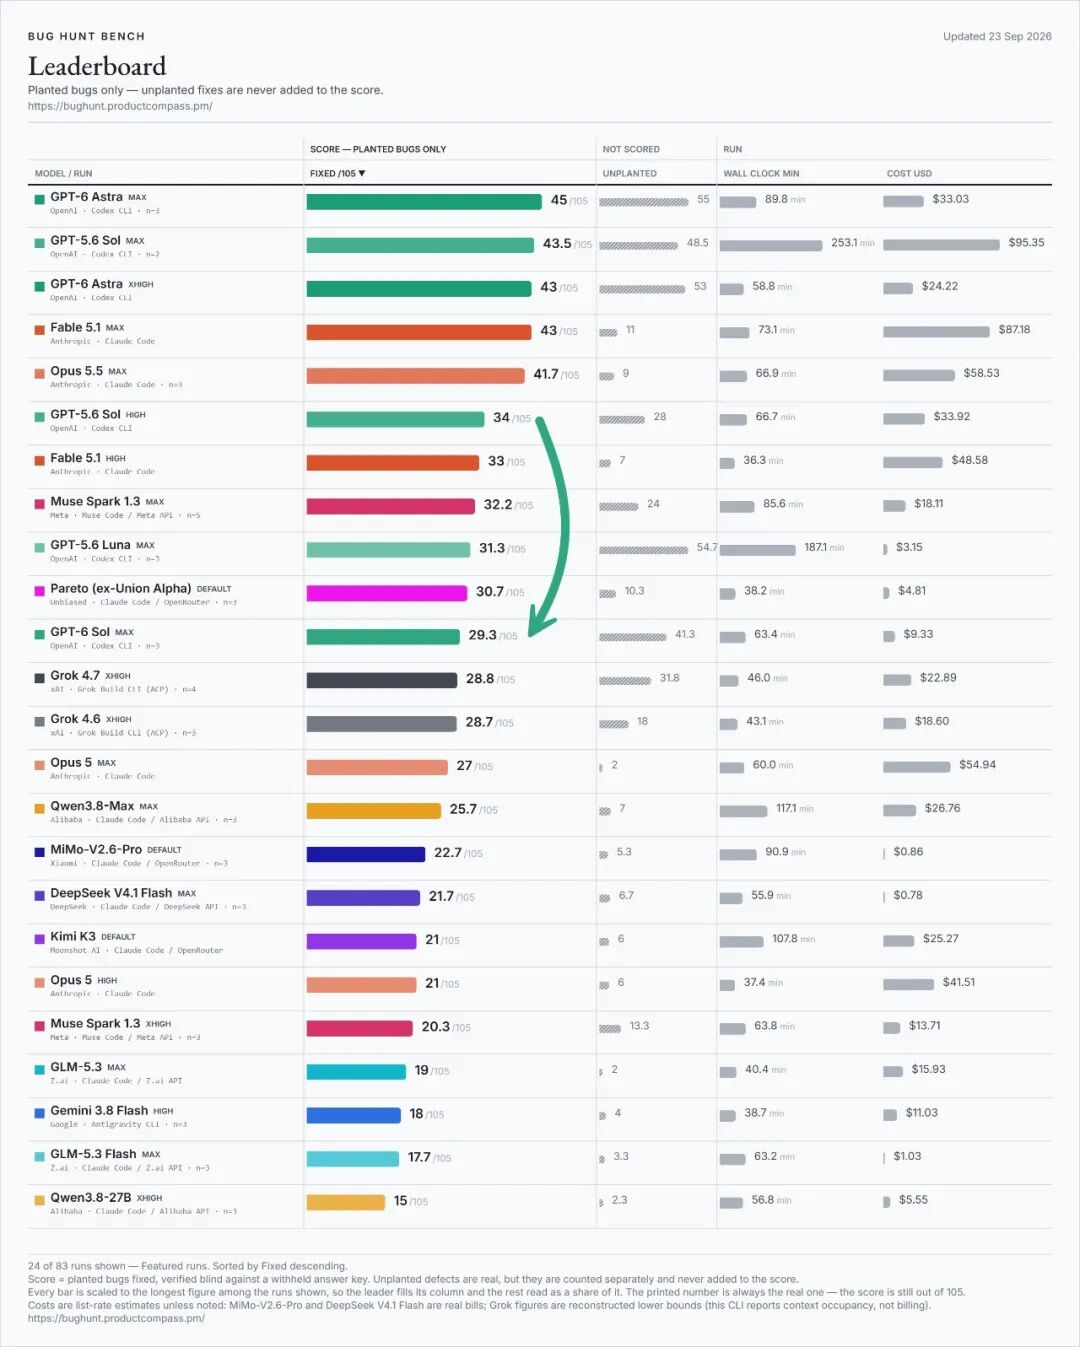
Twitter 有一个网友做的测试对比Pawel Huryn,他是通过“找 Bug”的方式来测试整个模型的编码能力。
这个测试一共准备了 150 个模型比较容易漏掉的 Bug,而且这些 Bug 全部来自两个真实的生产级项目,所有模型都会做完全一样的题目,然后看它到底有没有找到问题、有没有真正把 Bug 修好。
第一个项目叫 GrokBuild,是他自己基于 VS Code 和 Cursor 做的一个扩展。当时这个项目大概有 2.8 万行 TypeScript 代码,里面准备了 45 个 Bug。当然,这些 Bug 在正式项目里其实都已经修好了,他为了做测试,又把有问题的老版本重新拉回本地。
第二个项目他没有特别细说,主要是一套 AI 做的课程系统,大概有 6 万行代码,前端主要使用 Vite、React 和 TypeScript。这个项目里面同样准备了 60 多个 Bug,而且答案肯定也是没有公开给模型的。
整个测试结果其实挺出乎意料的。
太长了?我帮你精简下...
GPT-6 Astra | max,3 次平均 | 45 | 33 美元 |
GPT-5.6 Sol | max,2 次平均 | 43.5 | 95 美元 |
Opus 5.5 | max,3 次平均 | 41.7 | 59 美元 |
GPT-5.6 Terra | max,1 次 | 32 | 28 美元 |
GPT-6 Sol | max,3 次平均 | 29.3 | 9.3 美元 |
GPT-6 Sol | xhigh,1 次 | 25 | 7.7 美元 |
GPT-6 Sol | high,1 次 | 20 | 4.2 美元 |
GPT-6 Luna | max,2 次平均 | 19 | 0.51 美元 |
GPT-6 Astra 下面,表现最好的是 5.6 Sol,然后是 Opus 5.5,再往下是 5.6 Terra,最后才是 GPT-6 Sol。
性价比确实很高,符合便宜输出又短的特点!价格甚至只有上一代高档模型的10%左右,但是它整个“智商”的下降实在太严重了。至少从这组真实项目测试来看,编码能力的差距非常明显。
也就是说,如果我们真的把这个模型拿到生产环境里去用,虽然模型本身便宜了,但是最后你可能会发现,你得浪费大量时间去纠正它犯下来的错误。模型费用省下来了,人的时间又赔进去了。
再往细了看,GPT-6 Sol 开到 Max 档,三次测试平均只能修好 29.3 个 Bug;而 GPT-5.6 Sol 开到 Max 档,能够修好 43.5 个左右。
换句话说,GPT-6 Sol 的最高档 Max,可能大概也就是上一代 5.6 Sol Medium 左右的水平,甚至还远远不如 Opus 5.5,可怕的是竟然还比不过 5.5 Luna Max...
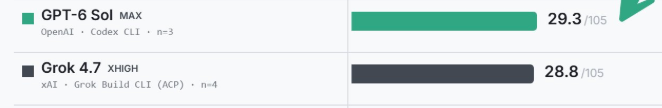
所以从整个测试结果来看,GPT-6 Sol 现在真正能够赢下来的,好像就只剩一个:便宜,值得和 Grok 4.7 坐一桌了..
而且我们也关注到,其实在官方自己提供的一些图表里面,GPT-6 Sol 也并没有真正超过上一代, DeepSWE上一代模型的成绩依然能够做到 72.7% 左右,而 GPT-6 Sol 大概只有 68.8%。
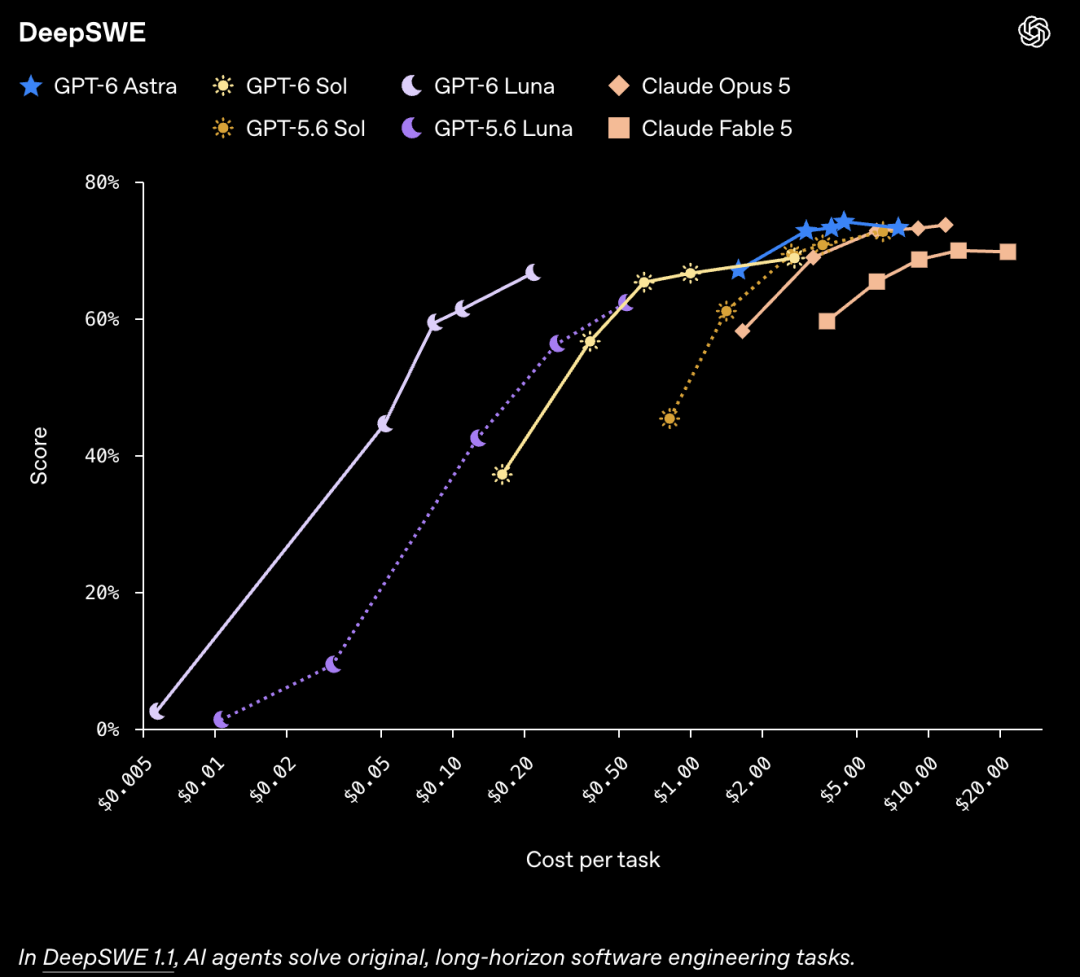
这DeepSWE测试集其实早就已经被各家模型刷烂了,在这种情况下,新模型竟然还能比上一代差一点,那到了真正未知的编程问题里面,这个差距可能就完全不是表面上的 4% 了。
公开题库里面差 4%,放到真实生产环境里面,可能就是10倍甚至更大的差距,你看Pawel Huryn的测试结果不就是这个道理吗?
Computer Use 方面其实也是类似的问题。
我们知道 GPT-6 Astra 的 Computer Use 能力是真的强得有点离谱。官方这次虽然一直在强调 GPT-6 Sol 使用了类似 Astra 的方法,但是从实际结果来看,它在电脑操作方面依然没有真正超过 5.6。
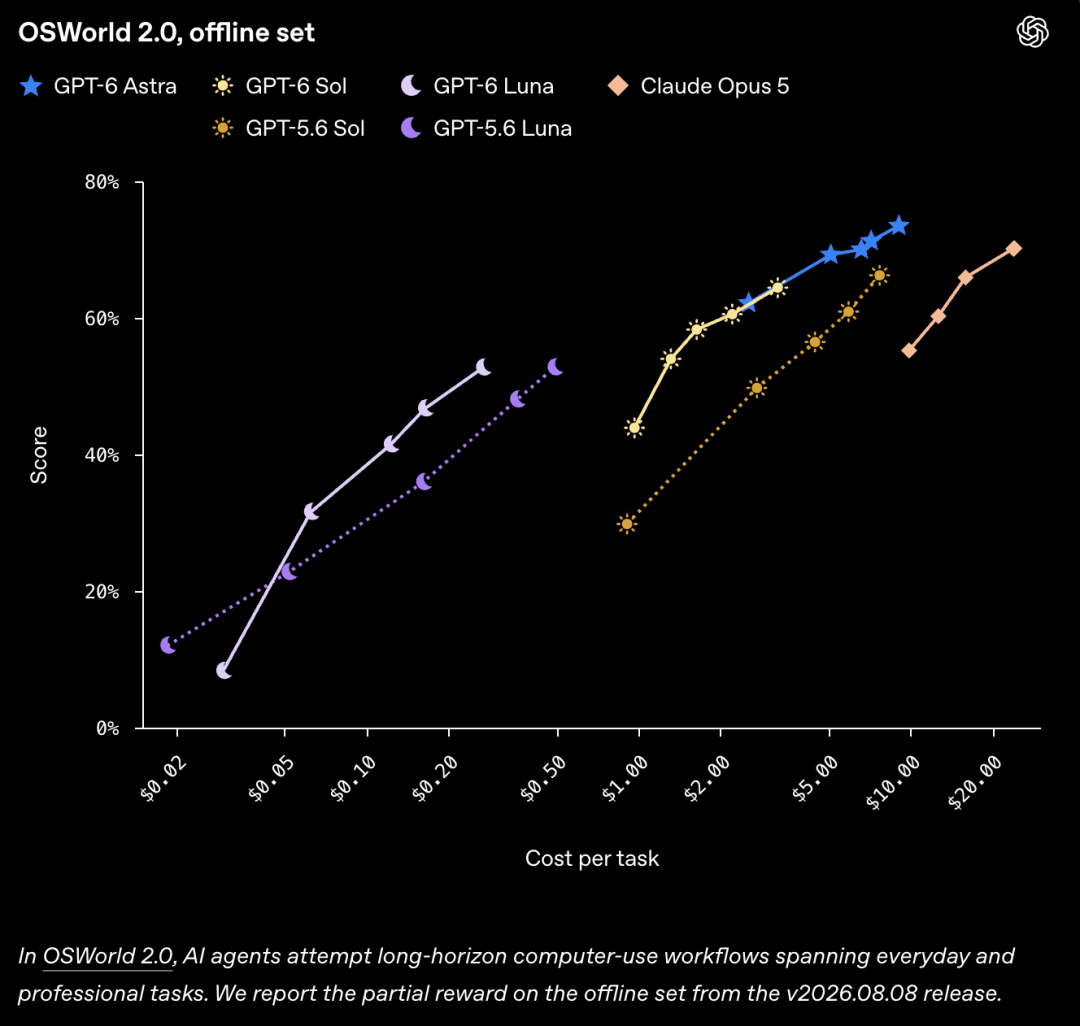
所以到最后,我们又只能夸它一句:便宜。
“哇,GPT-6 Sol 好省啊,跑了半个小时才掉 1%。”
但是然后呢?
其实我对新一代 GPT-6 Sol 的要求真的一点都不高。我只希望它能够达到上一代 5.6 Sol 的水平,然后速度再快一点,便宜点就已经完全满足了,
包括 Computer Use,我本来还挺期待 Luna 能有一个比较好的表现。但是如果 GPT-6 这一代的中低档模型整体都是现在这种水平,那我觉得 Luna 基本上也没有太大的测试必要了。
所以现在的问题就变得特别尴尬,Astra 太贵了,一个 X20 可能用个一两天就没了;Sol 确实便宜,但是智商又跟不上。
那大家到底应该怎么办?如果你真的在意效果、在意生产力,那我现在反而觉得,不如直接用 Astra,这才是版本的真正答案。
尽管官方现在已经把 Astra 的额度砍到了大概 1200 美金,而 5.6 Sol 加起来可能还有 2500 美金左右的额度,但是我们实际使用之后也会发现,5.6 Sol 真正消耗起来其实一点都不算省。
所以如果你真正关注的是任务质量和最终完成效率,那还不如直接用 Astra。
你可以理解成:
这一代的 Astra,其实就是上一代真正的 更便宜的“Sol”,但是 OpenAI 不会让你真正赚到便宜,token 输出少了,那就提价(当然可能算力真的更多吧);而这一代的 Sol,地球罢了。