


在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全“零参与”的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。
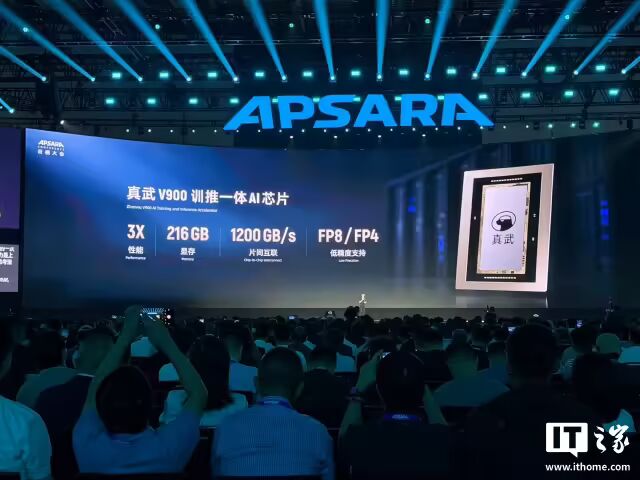
在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。
在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。