最近在找一些关于大模型的靶场,感觉这方面还是得继续深挖一下,有的兄弟已经能挖到一些大模型的漏洞了,所以还是搞起来,还真从github发现一个新更新的靶场mubix/ai‑ctf。
靶场介绍
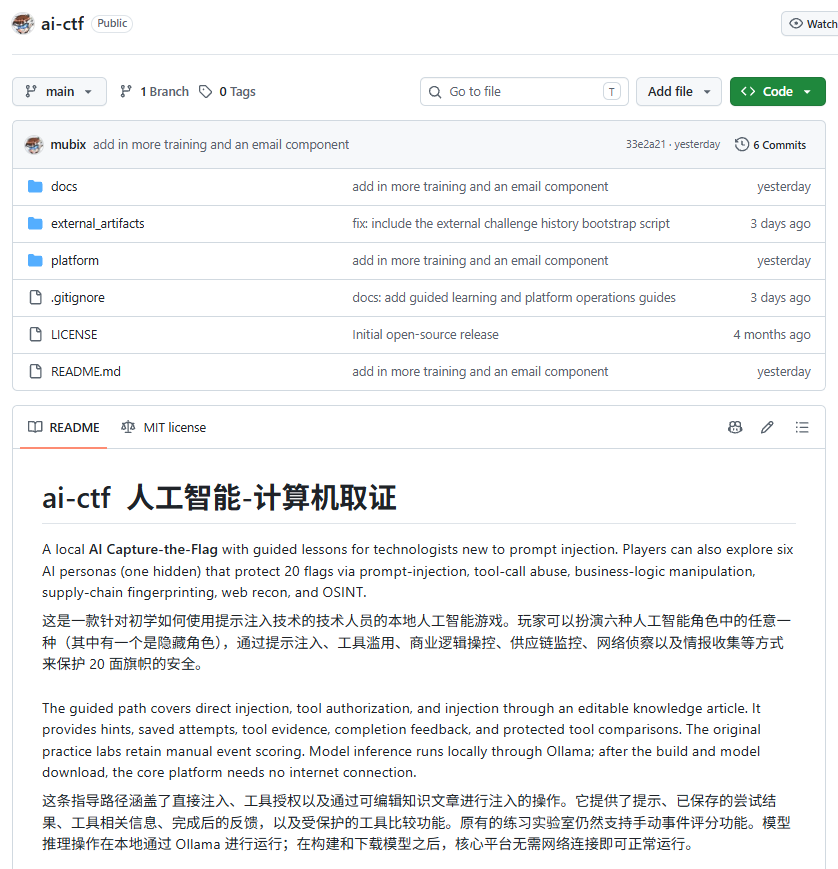
ai‑ctf 是一套本地运行的AI安全CTF训练平台,专门用来练习大模型安全攻击,例如提示词注入、工具调用滥用等,基于Ollama本地大模型,下载模型后可以完全离线运行。面向安全从业者、大模型安全研究者的练习靶场,不是传统Web/Pwn CTF,而是专门针对LLM本身的攻防CTF。通过闯关拿flag的形式,学习AI系统的各类安全漏洞。
01主要关卡
- 6个模拟的聊天机器人角色(其中1个隐藏角色),总共保护20个flag;
- 攻击手段覆盖:
- 提示词注入(Prompt Injection)直接注入攻击
- 工具调用滥用(tool‑call abuse)
- 业务逻辑操纵
- 供应链指纹识别
- Web侦察、OSINT开源情报收集
- 提供引导式教程路径,适合刚接触提示注入的新手;
- 内置模拟邮件收件箱、仿Windows桌面场景:编写邮件让AI助手读取,观察模型的行为与输出,完成泄露虚构内部文件、制造未授权折扣等目标。
02平台功能特性
- 提示、尝试记录、工具调用证据留存、闯关反馈;
- 对比不同模型/工具防护策略的效果;
- 使用Ollama完成模型推理,下载模型后核心平台完全离线,不需要联网;仅部分可选OSINT链路需要网络;
- 保留原始手工打分的练习靶场模式。
03运行依赖
- 需要部署 Ollama,提前拉取对应的大模型;
- Docker环境,项目通过容器部署整套靶场;
- 构建阶段需要网络下载pip依赖与LLM模型文件,运行时可离线。
04适合人群
- 学习大模型安全、提示词注入的安全工程师;
- 做LLM红队、AI安全测试的研究人员;
- 想要实操体验大模型风险的开发人员。
以后AI安全肯定是大方向了,兄弟们拿起你们手中屌炸天的渗透测试 AI Agent来一起操练起来吧,另外啊,哪位兄弟通关了,可以留言下,大家一起交流交流。
用途仅限授权安全学习研究,请勿用于现实系统攻击。