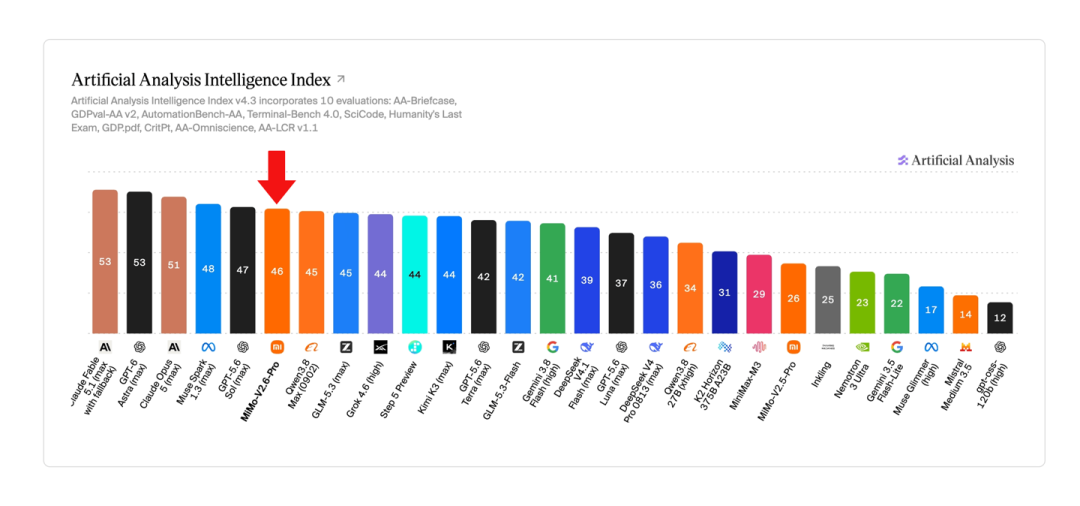
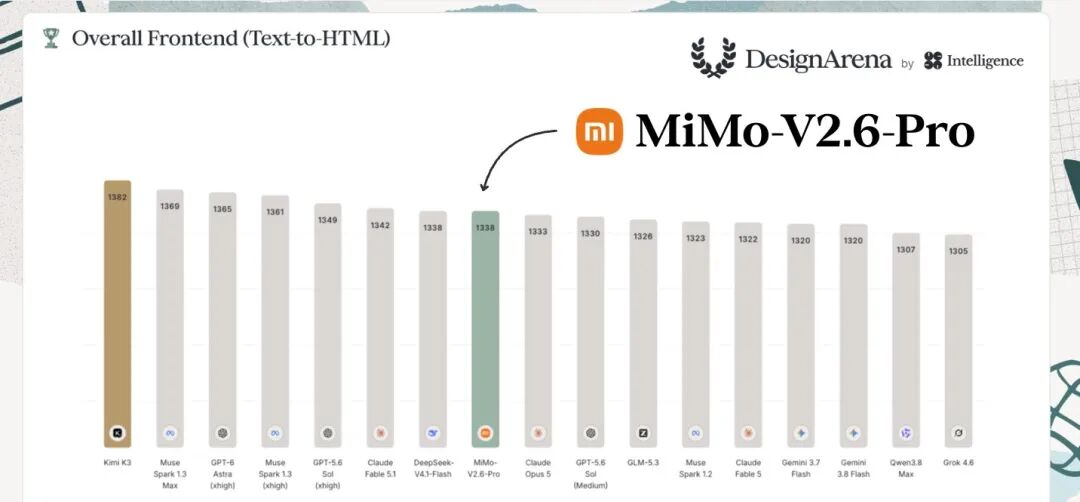
更大的 Batch 与更高吞吐,单次更新使用 1568 个样本,支持 100 万上下文长度训练,单步训练 Token 达 3.5 至 3.7B; 更多任务与复杂环境,构建覆盖 Code、General、Visual、Cyber 等方向的多任务训练体系; 更大的 Grader 算力,通过 Group 内相对比较为长程 RL 任务提供更精准的奖励信号。
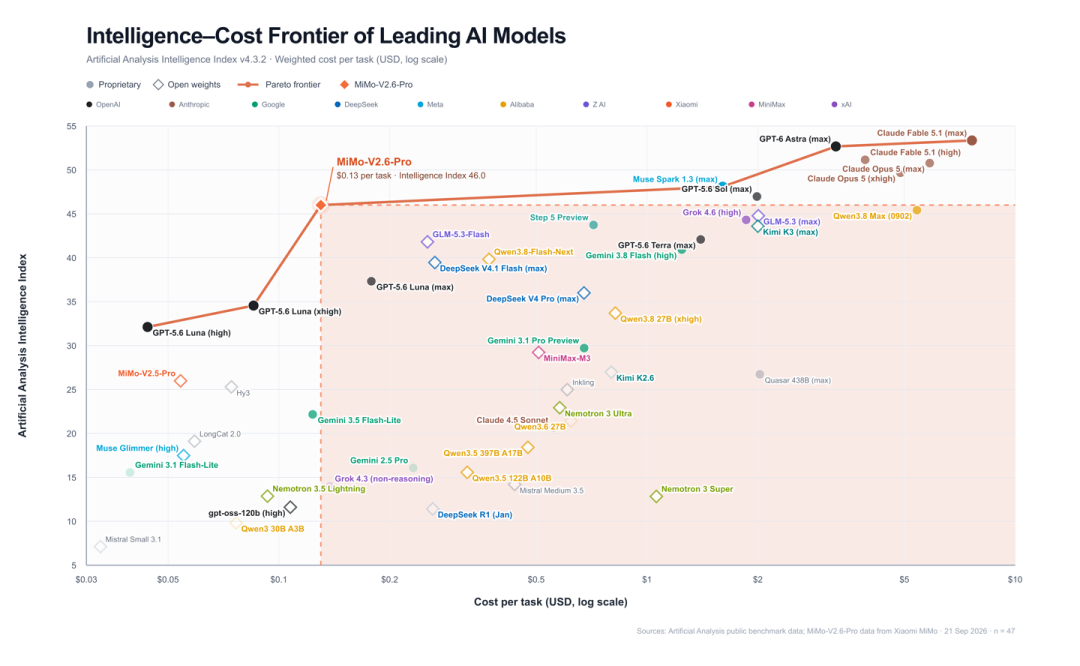
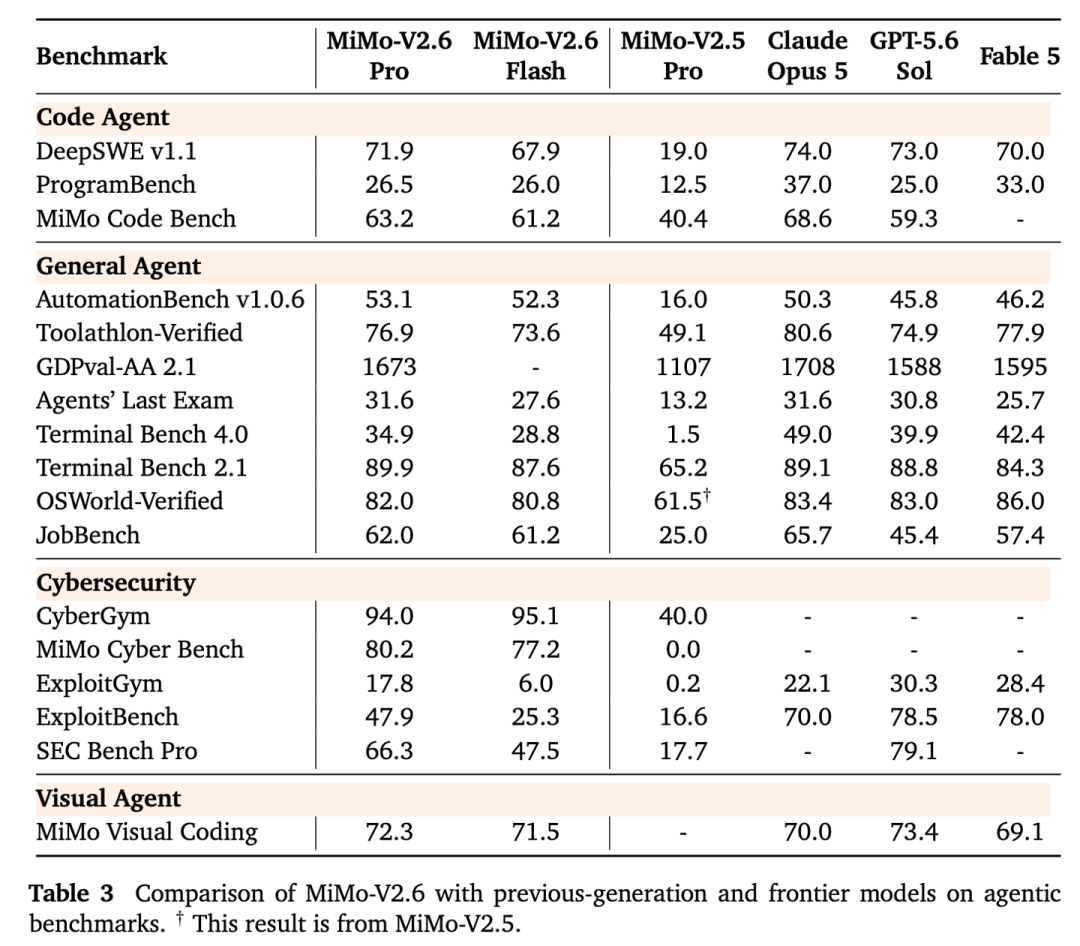
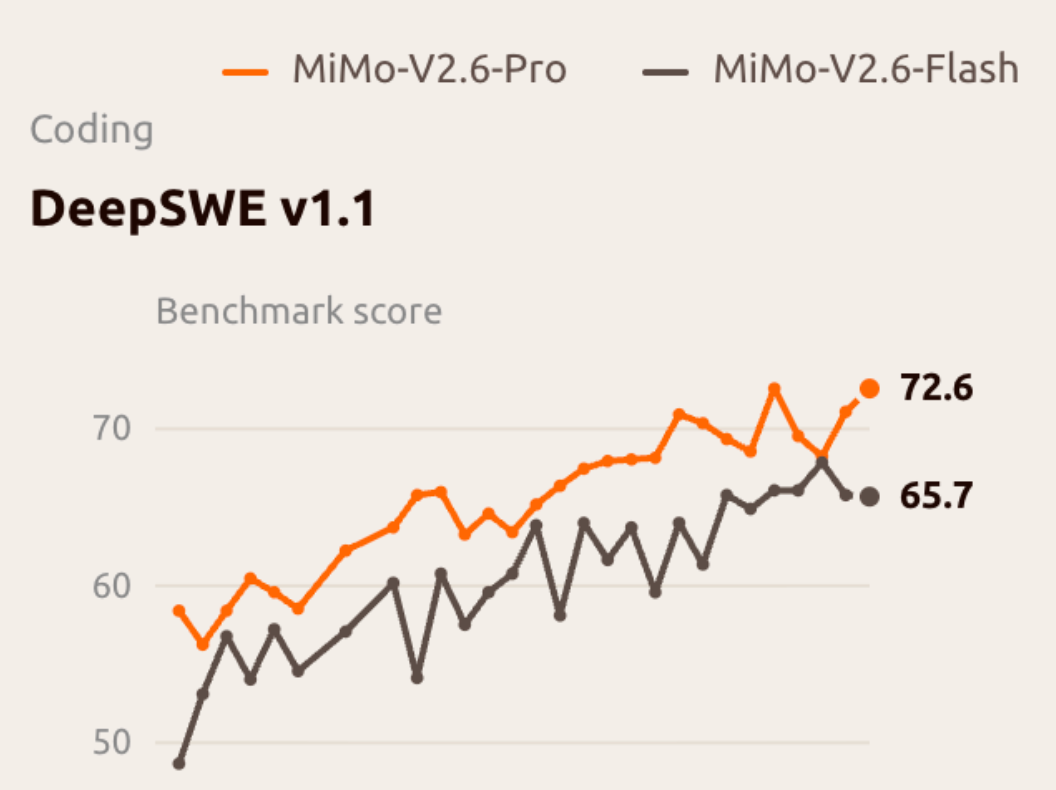
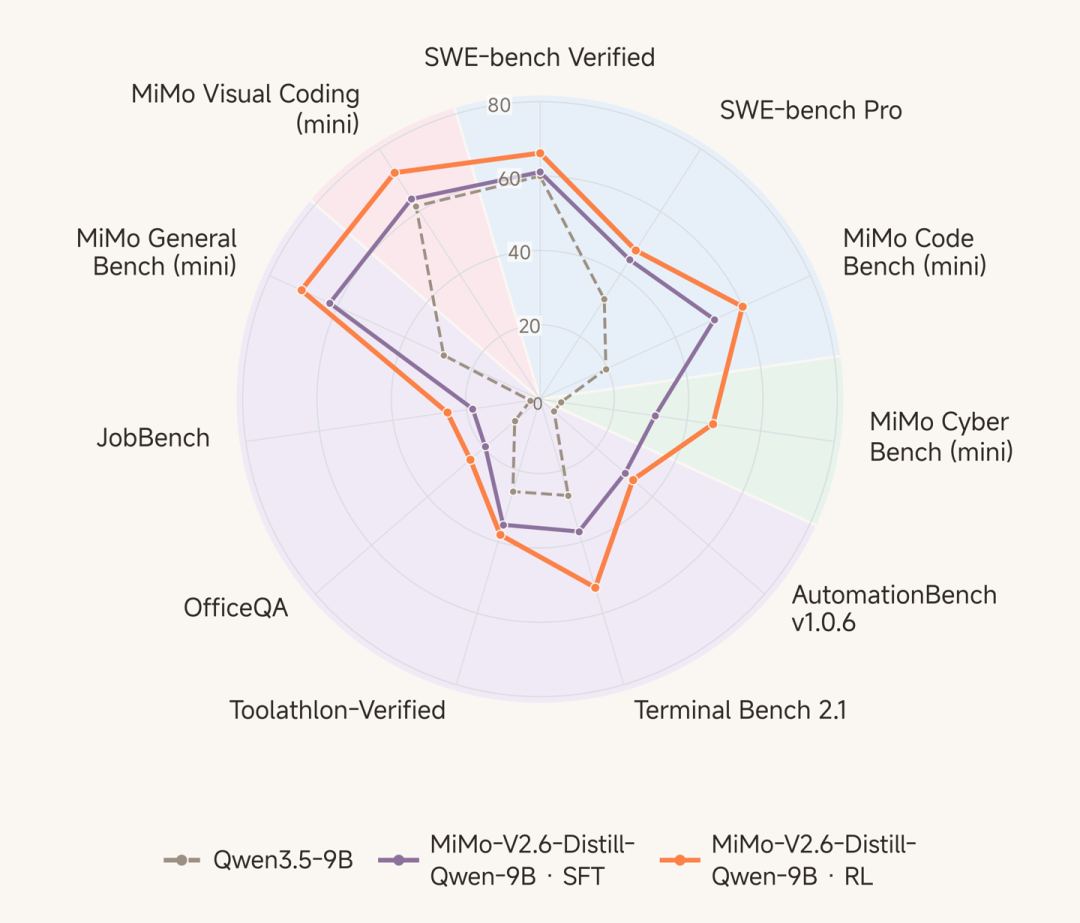
7k+ 高质量 RL 任务环境:覆盖软件工程、漏洞复现、知识型工作、网页设计开发四类智能体任务。以 MiMo-V2.6-Distill-Qwen-9B 为起点展开 RL 训练,在 11 项评测中均较 SFT 基线取得提升:SWE-bench Verified 从 61.1 提升至 66.2,MiMo Cyber Bench 从 31.3 提升至 47.0,Terminal Bench 2.1 从 37.1 提升至 52.8,MiMo Visual Coding 从 64.0 提升至 72.4;
端到端 RL 训练框架:基于 verl、uni-agent 和 mini-swe-agent,覆盖环境交互、轨迹采集、奖励评估与策略优化的完整训练流程。结合开放的模型与任务环境,支持社区围绕训练算法、奖励机制和 agent harness 开展研究与迭代;
轻量可组合的 Harness:开源极简 mini-harnesses,将系统提示、工具与上下文管理解耦,构建多样且可控的训练配置。通过 Multi-Harness Training,能够将多样性和整洁性纳入 RL 训练,提升模型在不同框架、包括未见框架上的泛化能力,支持社区自由组合框架组件、拓展训练配置,持续探索新的研究方向。