2026 年 9 月 21 日,xAI 正式发布 Grok 4.7,定位为面向编程、Agent 任务和知识工作的旗舰模型。
与 Grok 4.6 相比,Grok 4.7 使用了更大的新基础模型,并进行了更长时间的强化学习训练。
xAI 表示,Grok 4.7 的训练增加了更多需要数小时完成的复杂任务,模型在检查自身工作和管理长上下文方面得到提升,同时针对 Grok Bot 的运行框架进行了训练。
Grok 4.7 支持文本和图片输入、文本输出,上下文窗口为 50 万 tokens。推理强度提供 low、medium、high 和 xhigh 四档,其中 high 为默认设置。
API 价格与 Grok 4.6 保持不变。
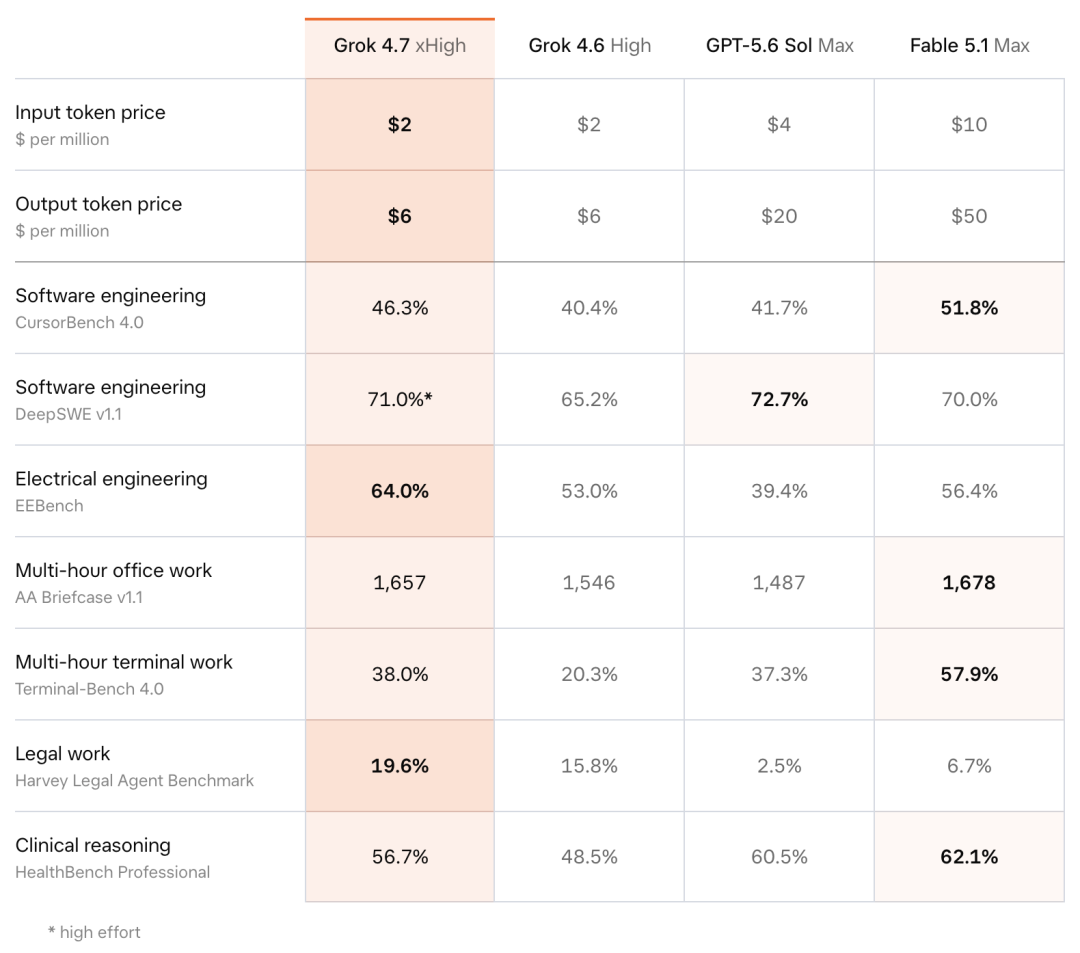
当 prompt 低于 20 万 tokens 时,Grok 4.7 每百万输入 tokens 收费 2 美元,缓存输入 0.5 美元,输出 6 美元;达到或超过 20 万 tokens 后,价格分别提高至 4 美元、1 美元和 12 美元。
xAI 同时提供 Grok 4.7 Fast。该版本使用相同模型,通过更快的基础设施提供约两倍的输出速度,token 价格为标准版两倍。目前 Grok 4.7 Fast 仅在 Cursor 和 Grok Build 提供,没有进入公开 xAI API。
在 xAI 公布的测试中,Grok 4.7 在 CursorBench 4.0 上取得 46.3%,高于 Grok 4.6 的 40.4%;Terminal-Bench 4.0 从 20.3% 提升至 38.0%;DeepSWE v1.1 得分为 71.0%。
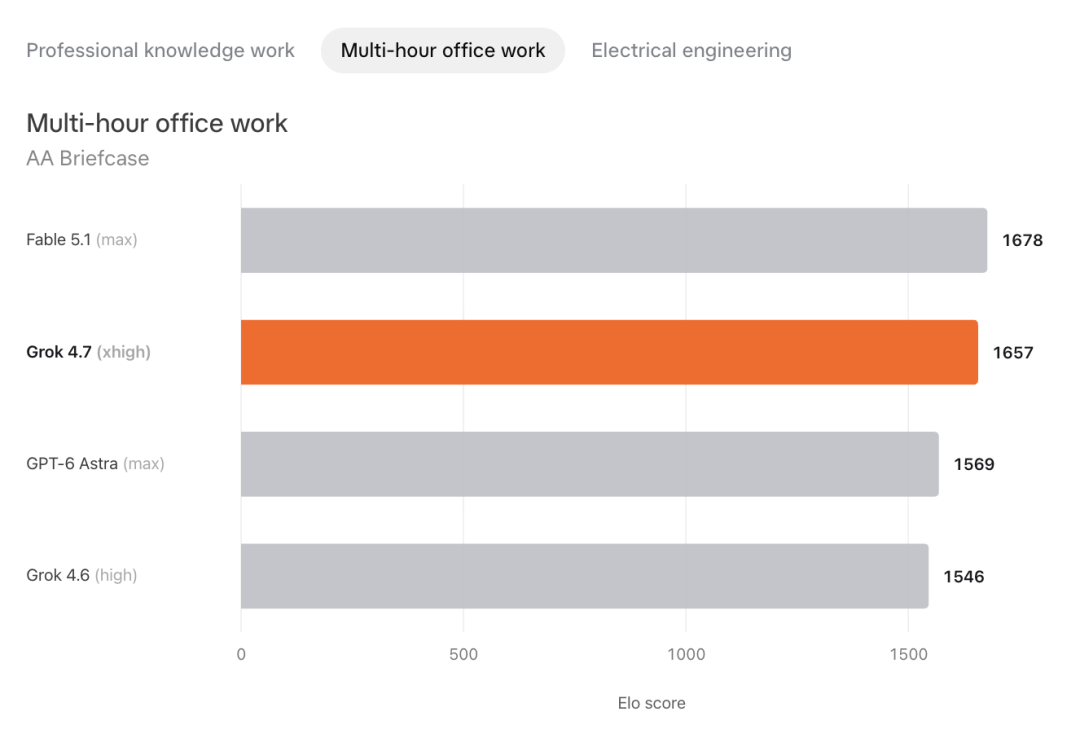
在多小时办公任务 AA Briefcase v1.1 中,Grok 4.7 得分为 1657,高于 Grok 4.6 的 1546。
Artificial Analysis 的独立评测显示,Grok 4.7 在 high 和 xhigh 推理档位下,Intelligence Index 均为 46 分。
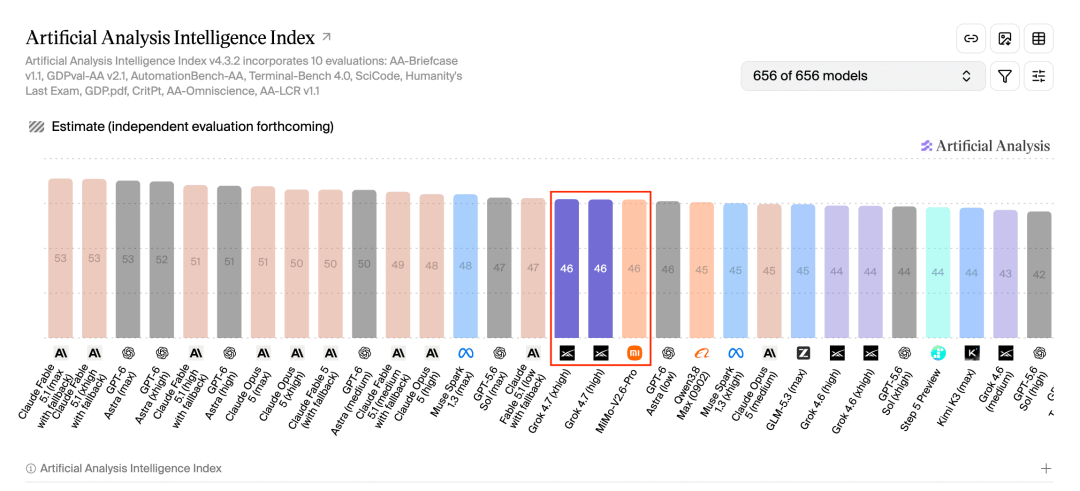
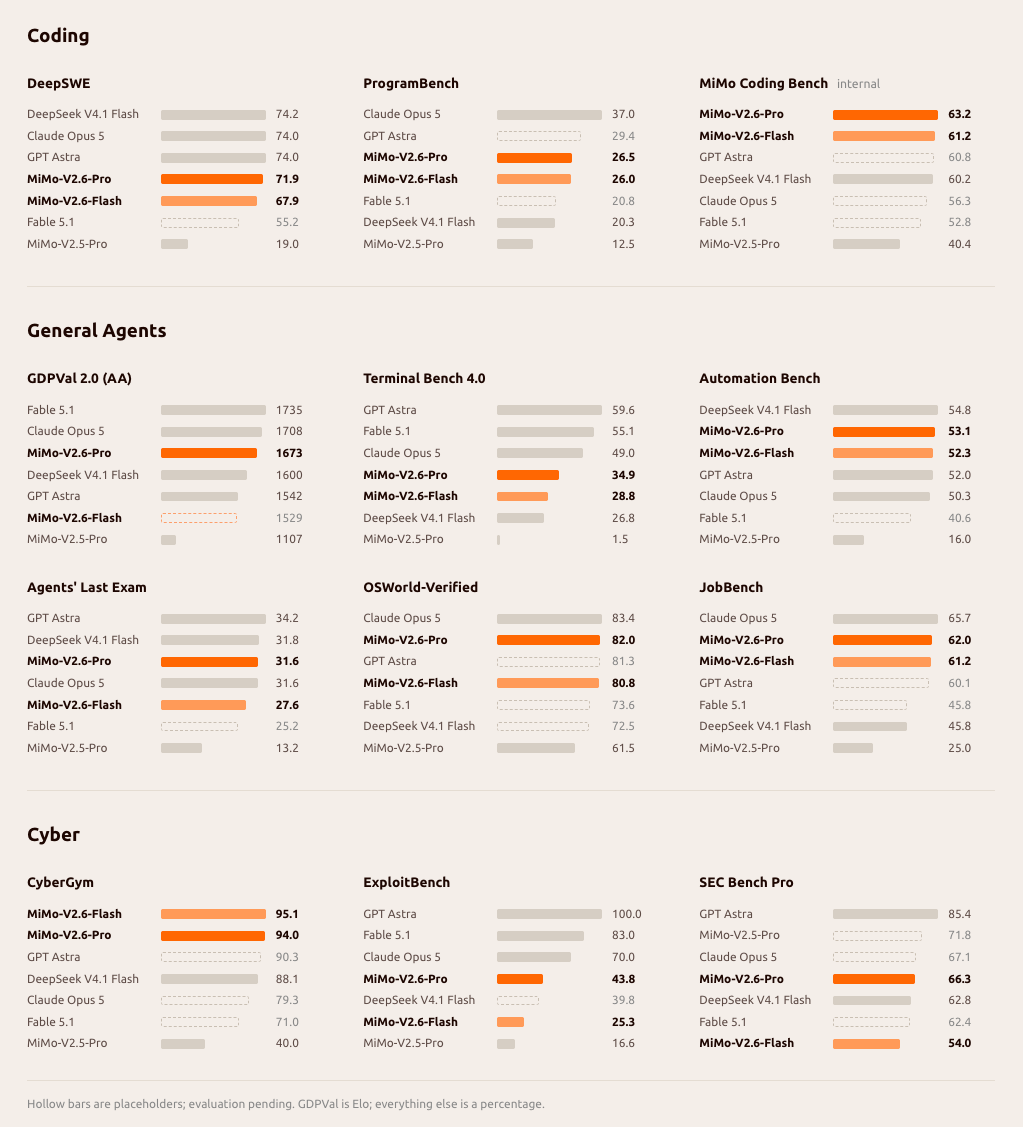
与此同时,小米发布了 MiMo-V2.6 系列。其中,MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index 上同样取得 46 分。
小米官方给出的精确成绩为 46.32 分,并称其为当前全球最强开源模型。
从 Artificial Analysis 这一统一综合指标来看,MiMo-V2.6-Pro 与 Grok 4.7 的成绩基本处于同一水平。
MiMo-V2.6-Pro 支持 100 万 tokens 上下文,最大输出长度为 12.8 万 tokens。其海外 API 每百万缓存未命中输入 tokens 收费 0.435 美元,缓存命中输入 0.0036 美元,输出 0.87 美元。
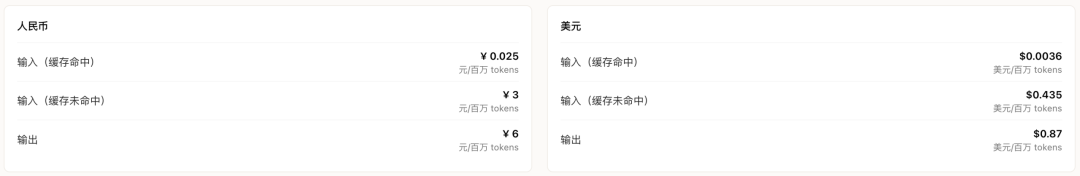
相比之下,Grok 4.7 在 20 万 tokens 以下的输入和输出价格分别为 2 美元和 6 美元。
云头条声明:如以上内容有误或侵犯到你公司、机构、单位或个人权益,请联系我们说明理由,我们会配合,无条件删除处理。