一 搜索引擎信息收集
搜索引擎
搜索引擎是指根据一定的策略、运用特定的计算机程序从互联网上采集信息,在对信息进行组织和处理后,为用户提供检索服务,将检索的相关信息展示给用户的系统。
搜索引擎的整个工作过程视为三个部分:一是蜘蛛在互联网上爬行和抓取网页信息,并存入原始网页数据库;二是对原始网页数据库中的信息进行提取和组织,并建立索引库;三是根据用户输入的关键词,快速找到相关文档,并对找到的结果进行排序,并将查询结果返回给用户。
1. 网页抓取
Spider每遇到一个新文档,都要搜索其页面的链接网页。搜索引擎蜘蛛访问web页面的过程类似普通用户使用浏览器访问其页面,即B/S模式。引擎蜘蛛先向页面提出访问请求,服务器接受其访问请求并返回HTML代码后,把获取的HTML代码存入原始页面数据库。
2. 预处理
网页预处理最主要过程是为网页建立全文索引,之后开始分析网页,最后建立倒排文件(也称反向索引)。Web页面分析有以下步骤:判断网页类型,衡量其重要程度,丰富程度,对超链接进行分析,分词,将重复网页去除。经过搜索引擎分析处理后,web网页已经不再是原始的网页页面,而是浓缩成能反映页面主题内容的、以词为单位的文档。
3. 查询服务
在搜索引擎界面输入关键词,点击“搜索”按钮之后,搜索引擎程序开始对搜索词进行以下处理:分词处理、根据情况对整合搜索是否需要启动进行判断、找出错别字和拼写中出现的错误、把停止词去掉。接着搜索引擎程序便把包含搜索词的相关网页从索引数据库中找出,而且对网页进行排序,最后按照一定格式返回到“搜索”页面。
搜索引擎语法
intext 将网页中的正文内容中的指定字符作为搜索条件
allintext 使用方法与intext类似
intitle 搜索网页标题中是否有指定的字符
cache 搜索搜索引擎里关于某些内容的缓存
define 搜索某个词的定义
filetype 搜索指定类型的文件
info 查找指定站点部分基本信息
inurl 搜索指定的字符是否存在于URL中
allinurl 也同inurl类似,可指定多个字符
linkurl 返回所有与指定链接做了链接的URL
site 搜索指定的域名
步骤
一,打开搜索引擎
在浏览器网址栏当中输入: https://www.bing.com或者https://www.baidu.com回车进入页面[1]
二,在搜索栏输入:
intitle在必应的语法中可以指定在标题中包含的内容,增加指定内容在搜索返回结果的权重。 intitle:admin 可以查看到以下页面: 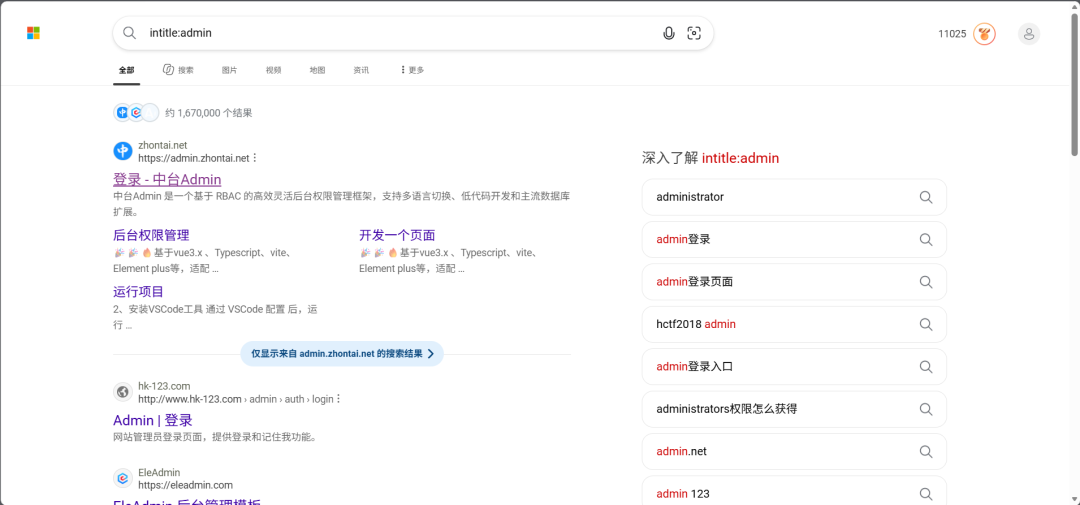
三,在搜索栏当中输入:
inurl在必应的语法中可以指定搜索返回的结果的网页的链接当中包含的内容。
inurl:admin_login 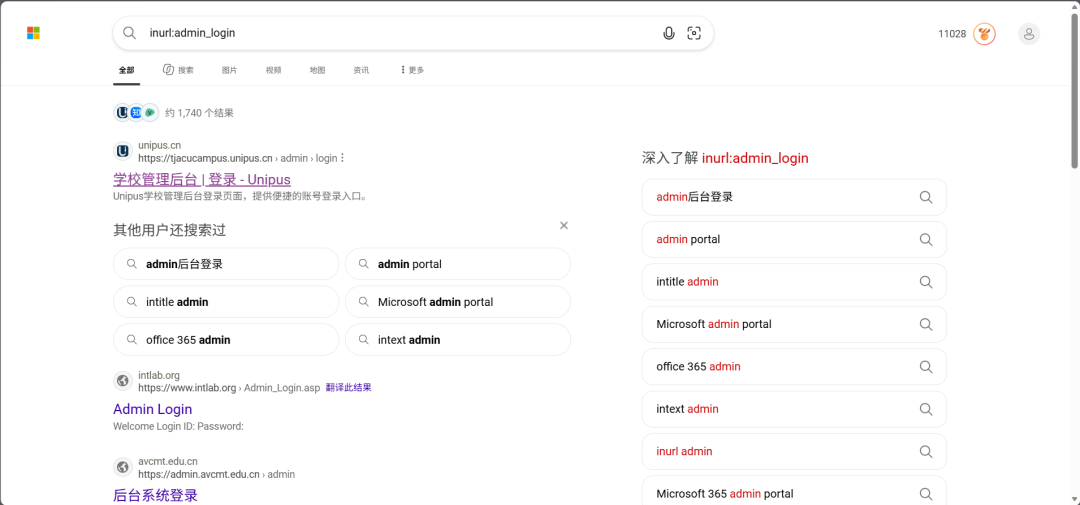
四,在搜索栏当中输入:
filetype在必应的语法当中可以指定搜索的内容的文件格式,包括pdf、
word、excel、txt、ppt等
intitle:java filetype:pdf 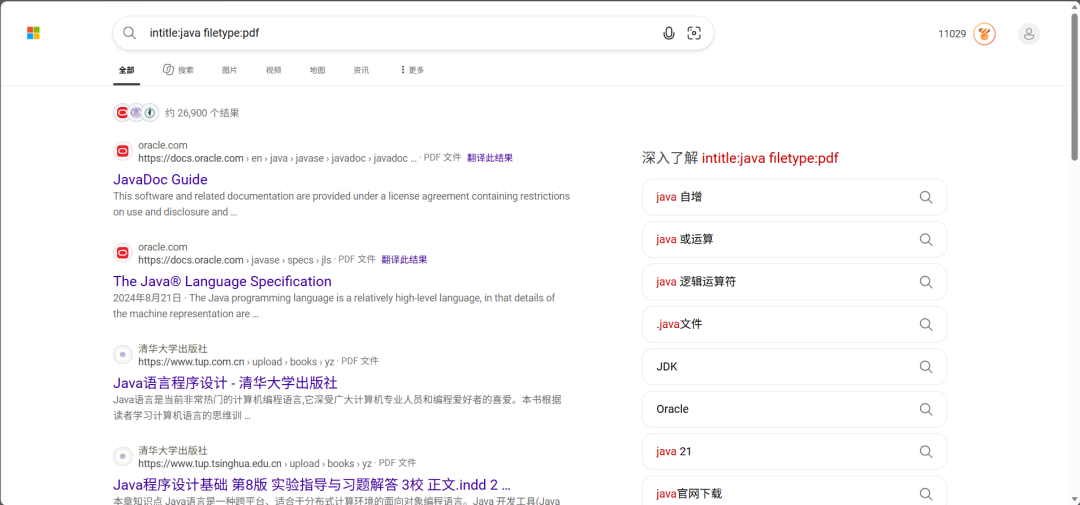
五,在搜索栏输入:
site在必应的语法当中可以指定搜索的返回结果的网页链接包含的域。
site:cppu.edu.cn 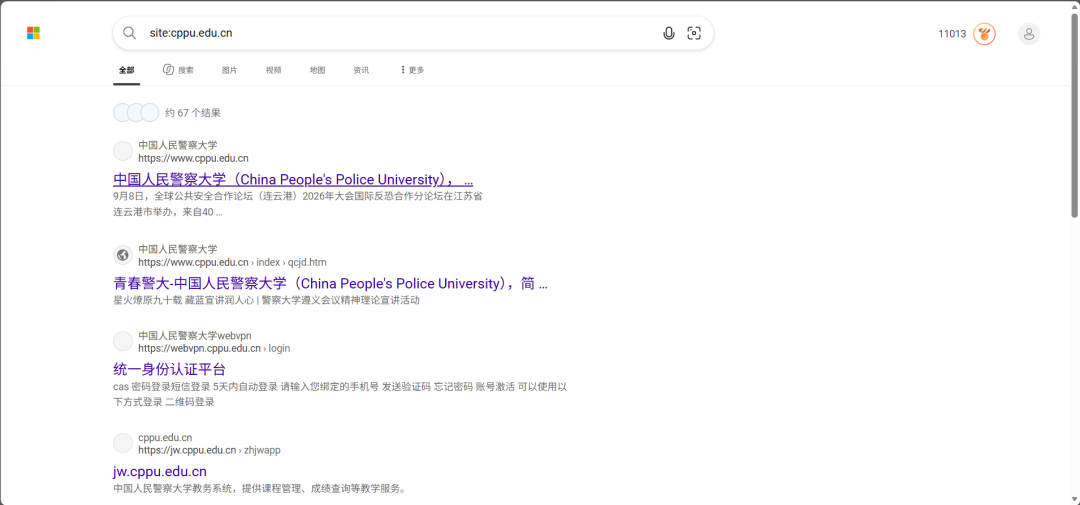
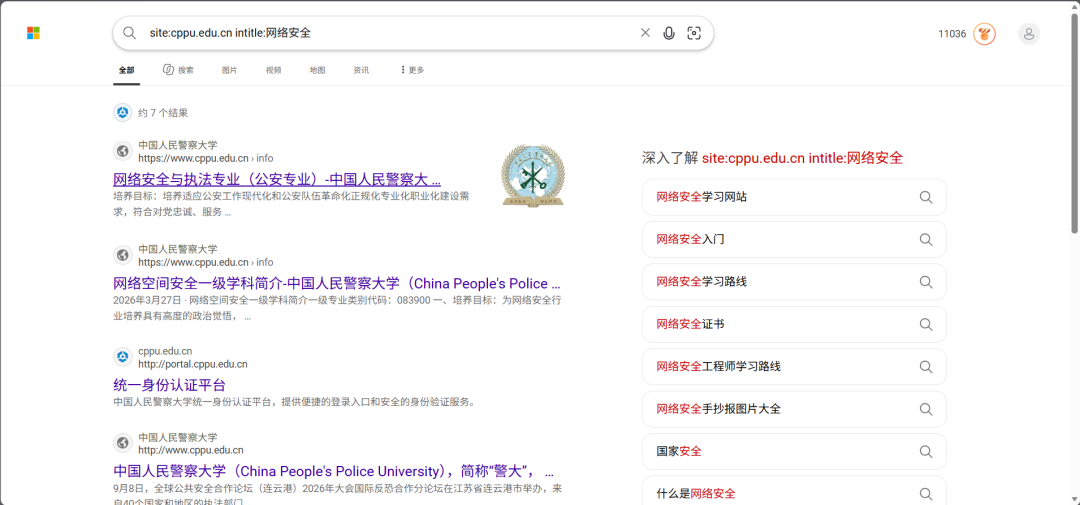
六,综合搜索
通过组合语法,可以精确搜索到想要的结果。
site:cppu.edu.cn intitle:网络安全
补充案例:Google Hacking 进阶语法演练
Google hacking的指令有site、inurl、intitle 、intext 、filetype 、link等。
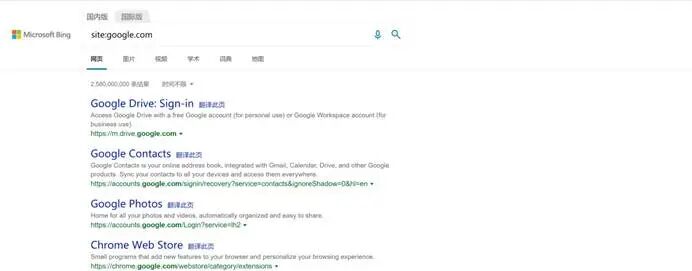
site用于子域名扫描,例如:【site:google.com】,可搜索google.com的子域名。
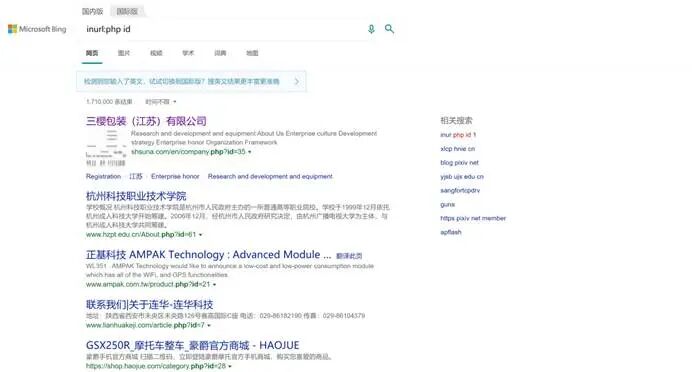
inurl用于搜索URL中存在关键字的页面,例如【inurl:php id】可搜索可能存在SQL注入的网页。
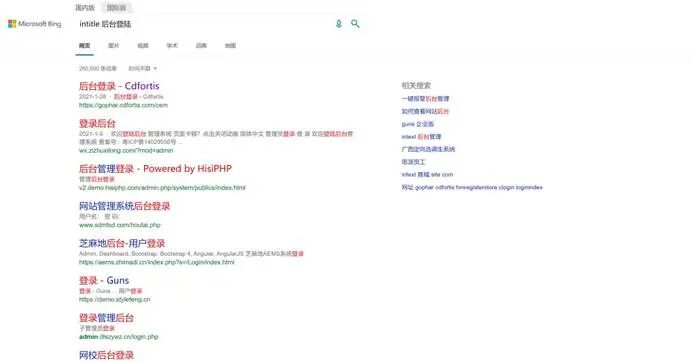
intitle 可用于搜索网页标题中的关键字,例如【intitle 后台登录】,可搜索后台登录的页面。
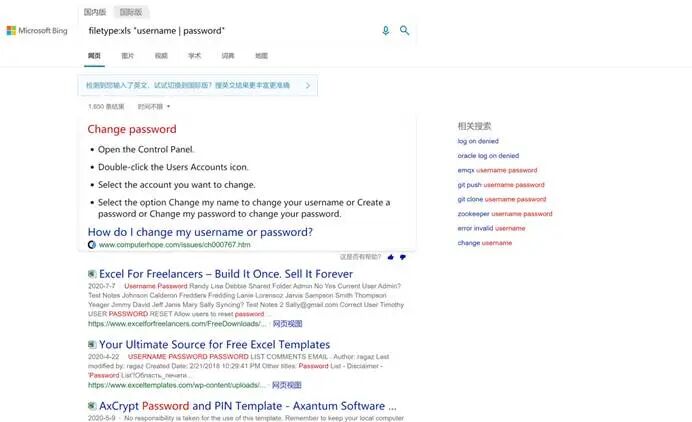
filetype可搜索指定的文件类型,例如【filetype:xls “username|password”】可搜索xls格式的用户名和密码文件。
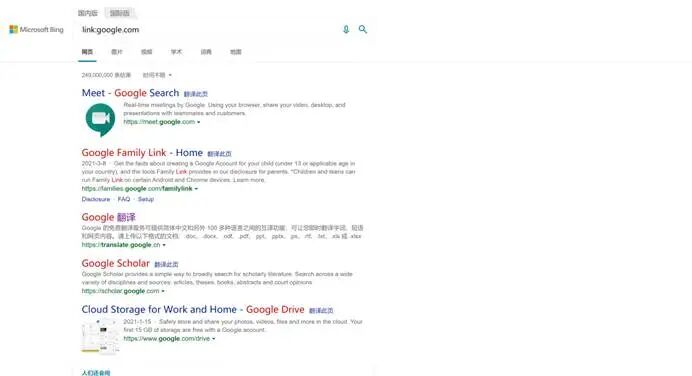
link可用于查找链接搜索域名的url,例如:【link:google.com】可搜索google.com的url。
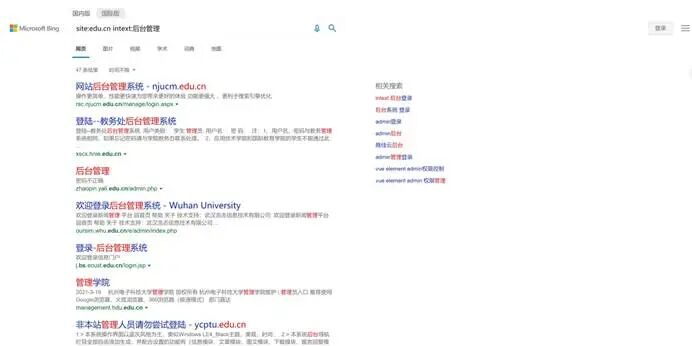
intext可用于搜索网页正文中的关键字,例如【site:edu.cn intext:后台管理】可用来搜索一些学校的后台。
二 Whois 与备案信息查询
相关知识
域名是由一串用点“.”来分隔的字符串组成的Internet网上某一台计算机或一组计算机的名称,用于在数据传输时对计算机进行定位标识,一个域名会映射到一个或多个IP地址。
渗透测试过程中,通过域名查询信息的方式包括Whois查询、备案信息查询等。Whois查询就是一个用来查询域名是否已经被注册、注册域名的详细信息的数据库,可查询的信息包括域名所有人、域名注册商、域名注册日期和过期日期,还有域名归属者联系方式,这些信息在后续针对该域名的爆破攻击中十分有用。
网站的备案信息是根据我国的法律法规规定,由网站的所有者向国家有关部门申请的备案,这是国家工业和信息化部对网站的一种管理方法,主要为了防止在网站所有者在网上从事非法的网站经营活动。网站备案信息的局限性在于它主要针对国内网站,如果网站搭建在其他国家,则不会有备案信息。查询网站备案信息的渠道有:站长之家(http://icp.chinaz.com/)和天眼查([https://beian.tianyancha.com/](https://beian.tianyancha.com/))。[2]
Whois信息查询的渠道包括:站长之家([3]http://whois.chinaz.com)、Whois[4]官网(https://www.whois.com/)、爱站工具网([https://whois.aizhan.com)、Godaddy](https://whois.aizhan.com)、Godaddy)(https://sg.godaddy.com/)。[5]
步骤
以【google.com】为例,打开浏览器搜索站长之家网站。 在站长工具中查询到【google.com】的Whois信息如下所示。 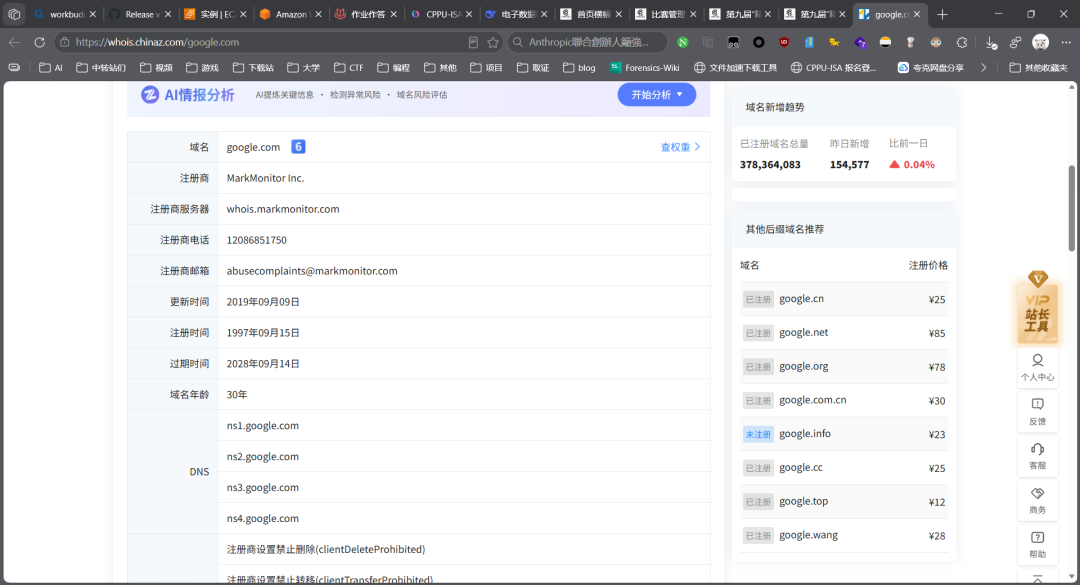
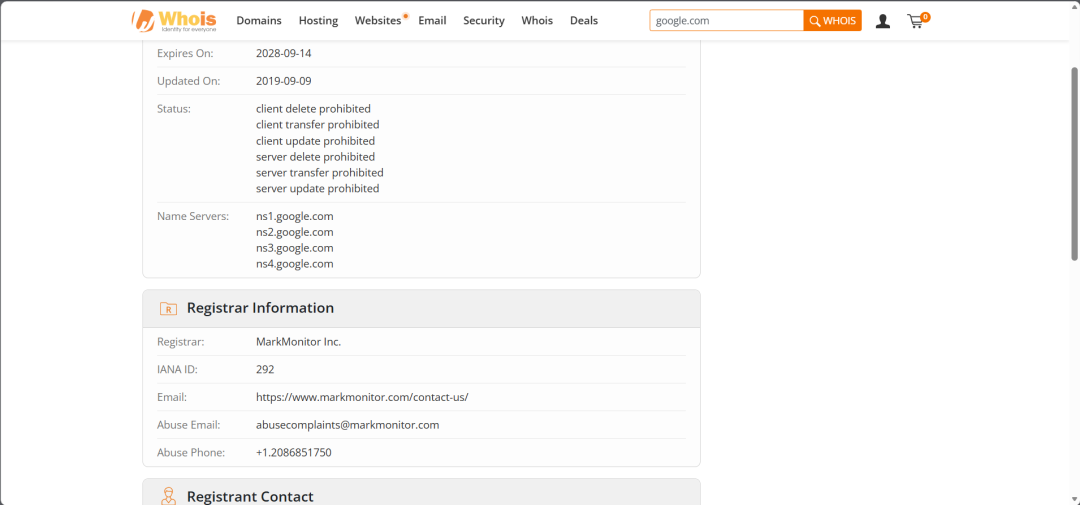
可看到站长之家中的Whois信息有注册商及域名的联系邮箱等,但其联系电话未显示全部信息。要查看全部的信息,可在Whois官网或Godaddy官网查看,具体信息如下图所示:
三 网站技术信息查询
相关知识
netcraft是一个可以查询到大部分知名网站详细信息的网站,可检索到的信息包括网站运行服务器的类型、所使用的Web服务器类型,甚至可能包含服务器所在的机房信息。
步骤
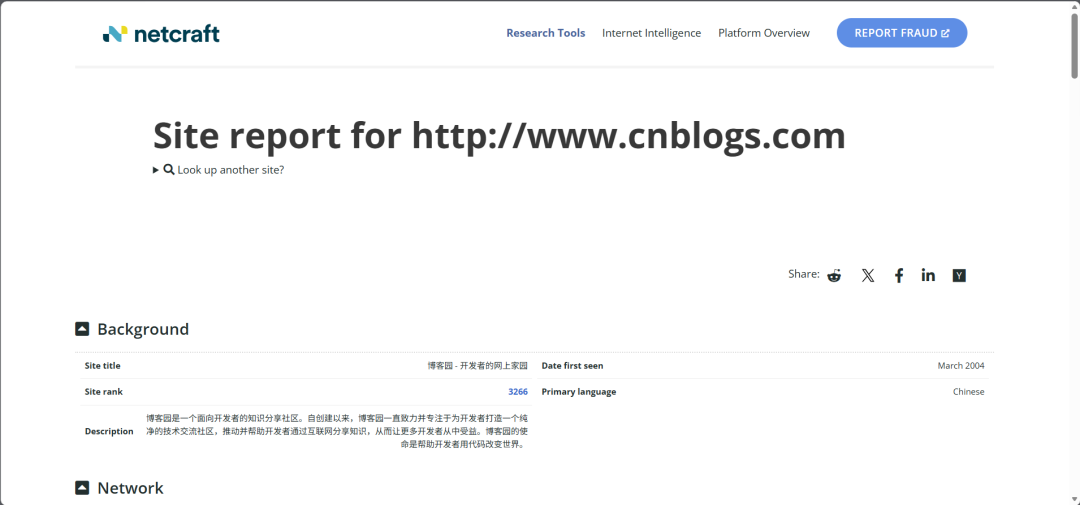
netcraft的网址为[6]https://sitereport.netcraft.com/[7],以博客园的网站域名【www.cnblogs.com】为例,在搜索框中输入并查询。netcraft的查询结果包含背景描述、网络、SSL、主机历史、反垃圾邮件信息、电子邮件协议信息、Web跟踪器信息以及网站技术信息等,在网站技术信息中,我们可看到网站客户端和服务器端使用的框架、语言等信息,这些信息在我们的渗透测试过程中是十分有价值的。[8]
四 DNS 信息收集(初级)
相关知识
子域名是指顶级域名下的域名,一个域名可分多级,每一级之间用“.”隔开,例如:youa.baidu.com,顶级域名指的是域名最右边的一级域名,比如例子中的.com,常见的还有.net、.org等。二级域名和三级域名分别是指倒数第二位以及倒数第三位的域名,比如例子中的.baidu和. youa。广泛而言,顶级域名下的都可以称为子域名。
在互联网早期时代,主机个数很少,用户访问某个主机时可通过IP直接访问,但IP地址这种点分十进制的表述方式不符合人类的记忆习惯,于是域名应运而生。虽然我们现在在浏览器中访问某个站点的时候是使用域名的形式,然而在地址解析的过程中,最终还是通过域名系统(DNS,Domain Name System)将域名解析为IP地址进行访问的。nslookup最初是一个对DNS服务器进行检测以及排错的命令行工具,我们可用其来实现将域名解析为IP地址,该工具由微软发布,在Windows操作系统中默认安装。
步骤
本按“子域名查询 → nslookup 解析 → dig 解析”的顺序完成 DNS 信息收集,形成从域名到 IP 的完整闭环:
子域名查询
子域名的查询渠道有https://tool.chinaz.com/subdomain/[9]
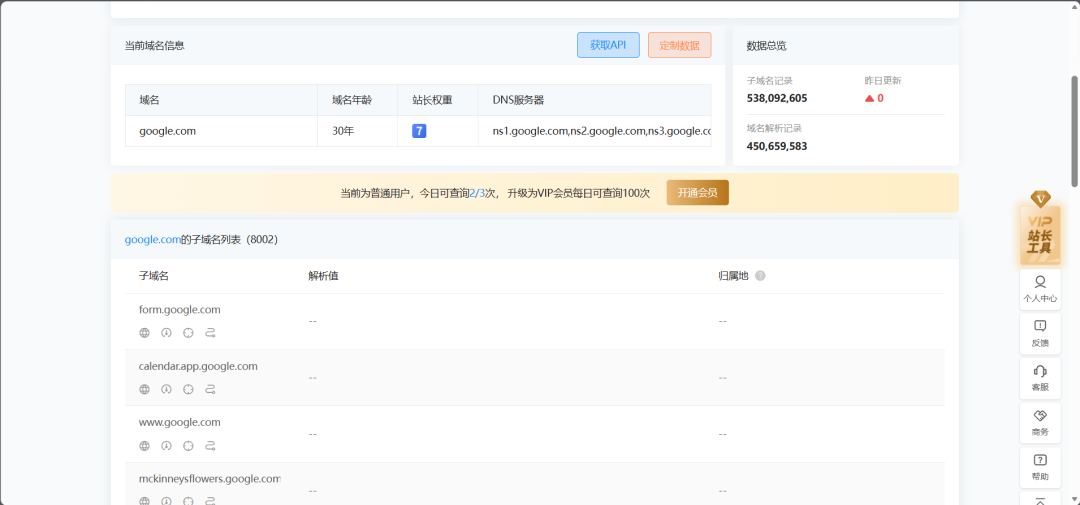
以【google.com】为例,搜索其子域名信息如下图所示,查询结果不仅提供了子域名信息,还提供了对应的IP信息。
nslookup 解析(Windows)
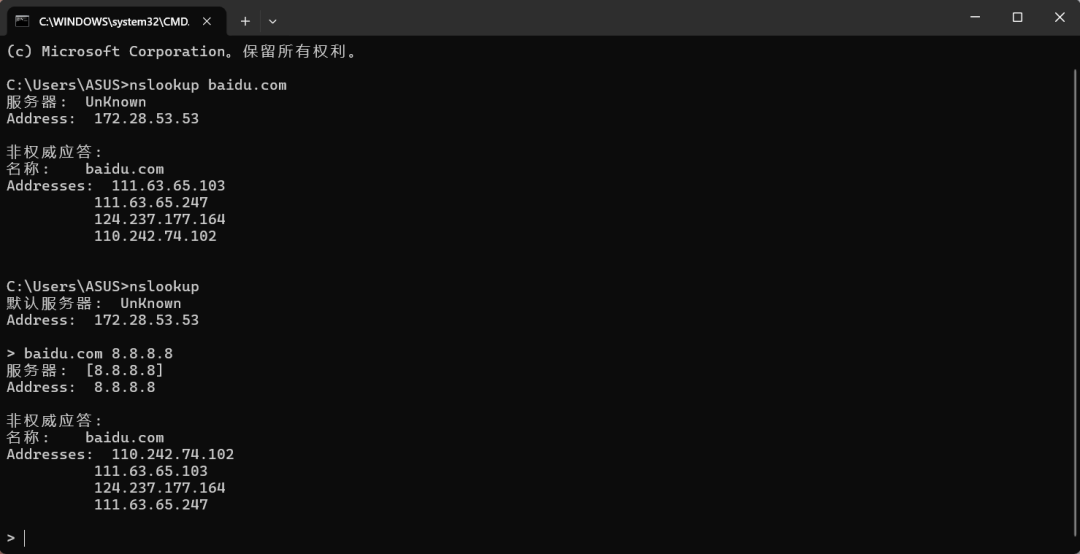
以【baidu.com】为例,打开Windows命令行,输入【nslookup baidu.com】可得到域名解析的结果。
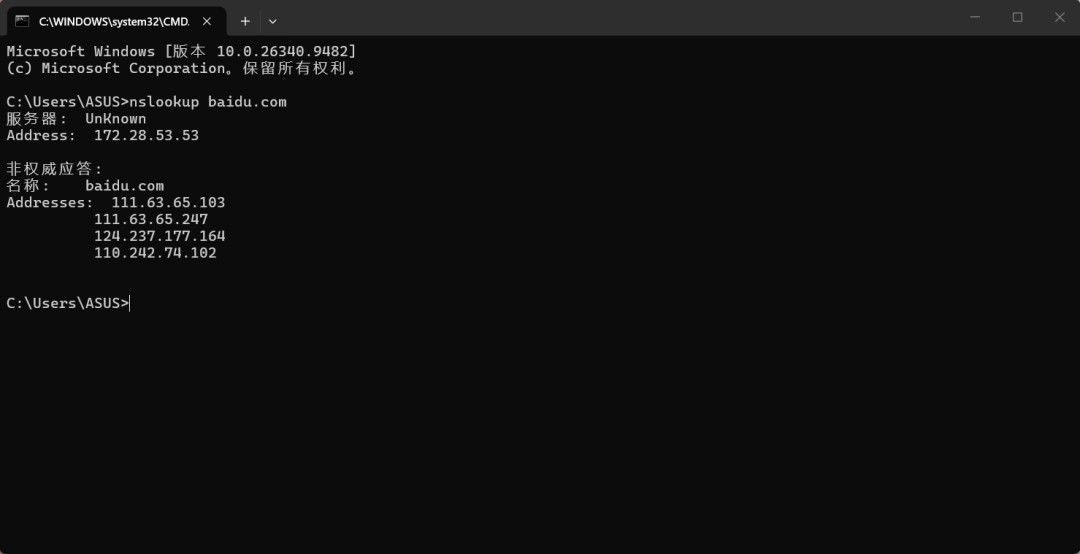
观察其域名解析结果可发现baidu.com的解析IP,使用这4个任意的IP直接在浏览器中访问,都是可以跳转到百度首页的。
nslookup工具也支持交互模式的使用,直接在命令行中输入【nslookup】将进入交互操作模式,在解析域名的时候,也可以指定使用的DNS服务器,指定方法是直接在查询域名后面追加使用服务器的IP地址,以使用谷歌的DNS服务器为例,在进入nslookup的交互模式后,键入【baidu.com 8.8.8.8】,将得到使用该DNS服务器解析的baidu.com的IP,退出交互模式的方式是键入【exit】。
dig 解析(Kali)
dig是域信息搜索器(DIG,Domain Information Groper),与nslookup类似,该命令也可用于执行域名解析。
同样以【baidu.com】为例,使用dig命令对其进行解析查询,其结果如下:
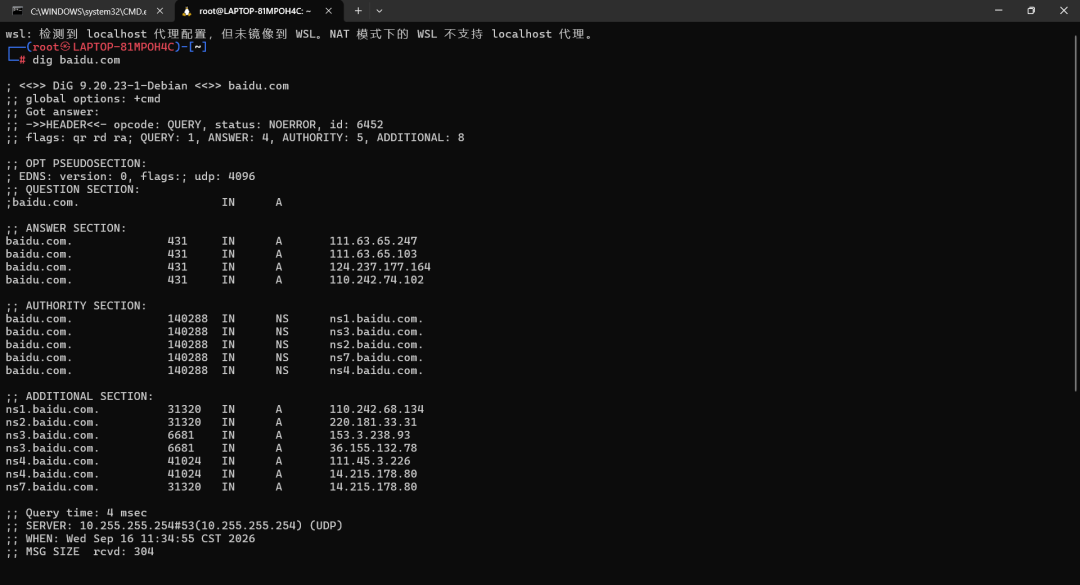
可以看到dig显示的信息比nslookup更加全面,除了域名解析的结果,还包含了域名服务器相关的信息。另外,dig指定DNS服务器的方式与nslookup略有不同,需使用【@】来表示DNS服务器,同样以使用google域名服务器解析baidu.com为例,其命令为【dig baidu.com @8.8.8.8】。
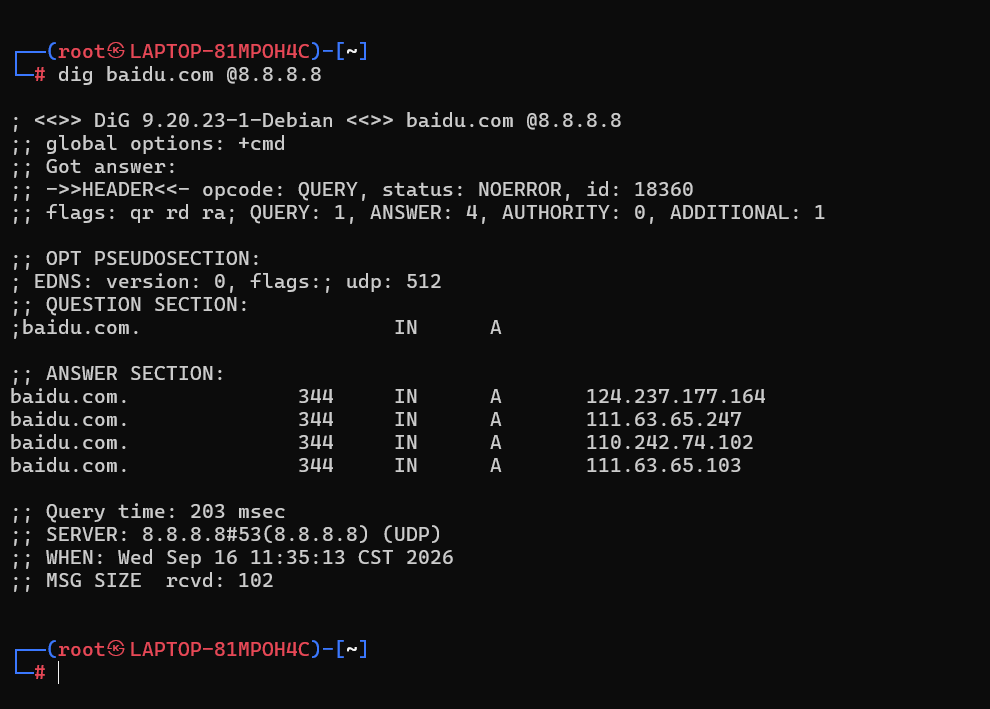
对比小结:nslookup 为 Windows 自带工具,输出简洁、便于日常快速解析;dig 输出信息更全面,包含域名服务器等细节,更适合排查分析。两者均支持指定 DNS 服务器查询(nslookup 直接后跟服务器 IP,dig 使用 @ 符号指定),可按操作系统与场景灵活选用。
五 IP 与设备测绘——shodan
SHODAN
与传统的搜索网址的搜索引擎不同,shodan是一款扫描收集设备信息的搜索引擎。其主要搜索目标为世界上大部分已联网的物理设备,这包含计算机、智能手机、路由器、摄像头、电站、智能标签,智能穿戴等。
通过对互联网的扫描,shodan可以发现物理设备的硬件信息以及服务信息,同时对于地理位置、漏洞等信息也能够进行扫描和抓取。
shodan语法
shodan网址:https://www.shodan.io/[10]
asn 区域自治编号
port 端口
org ip所属组织机构
os 操作系统类型
http.html 网页内容
html.title 网页标题
http.server http请求返回中server的类型
http.status http请求返回响应码的状态
city 市
country 国家
product 所使用的软件或产品
vuln CVE漏洞编号,例如:vuln:CVE-2014-0723
net 搜索一个网段,例如:123.23.1.0/24
shodan信息阅读
Banner:http、ftp、ssh、telnet
常见filter:
net(网络地址)
city(城市)
country(国家)
port(端口)
(系统)
hostname(主机或域名)
server(服务)
步骤
shodan简单使用
一,打开shodan网页并完成账号注册:
二,在搜索框中填入:
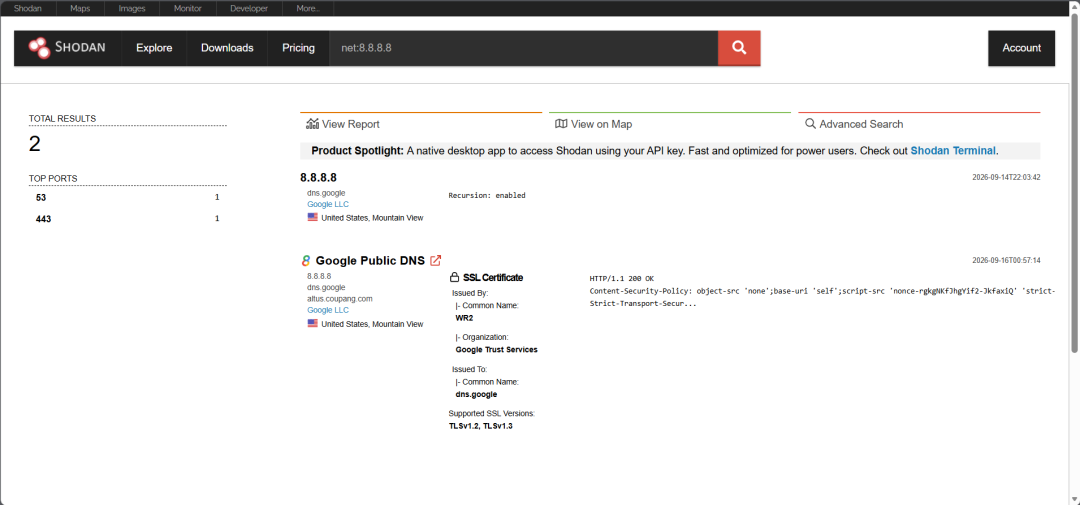
net:8.8.8.8
搜索后页面将会返回关于谷歌DNS服务器的一些信息:
三 点击Google Public DNS,进入主页,我们可以看到更加详细的信息:
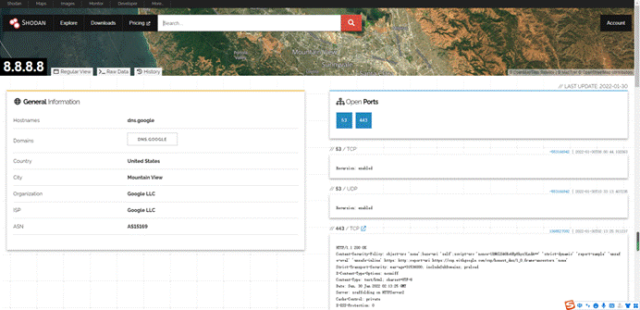
这些信息分别是:
地理位置:
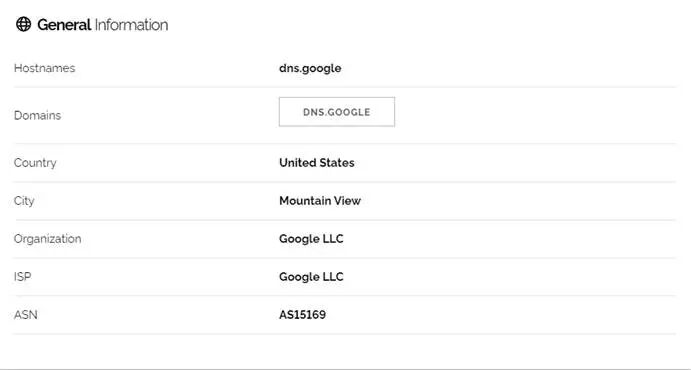
信息总览:
包含主机名、域名、国家、区域、所属组织等信息
端口:
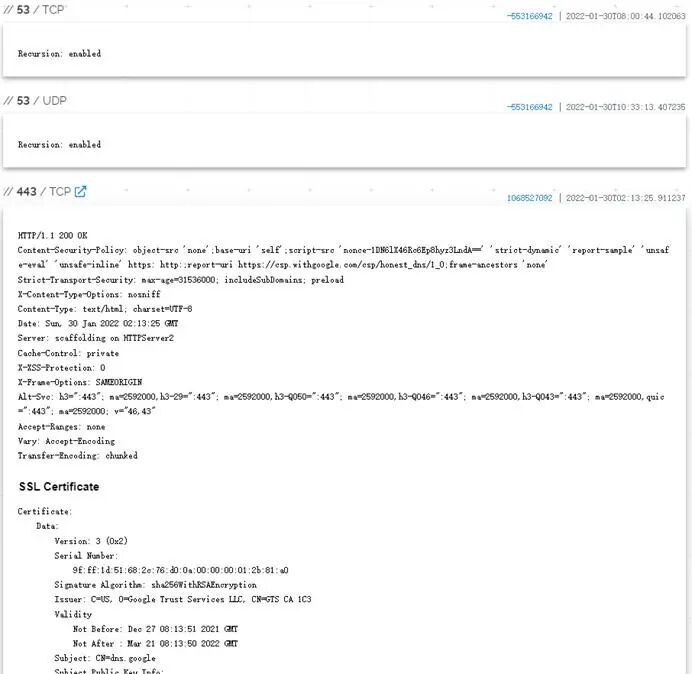
协议信息:
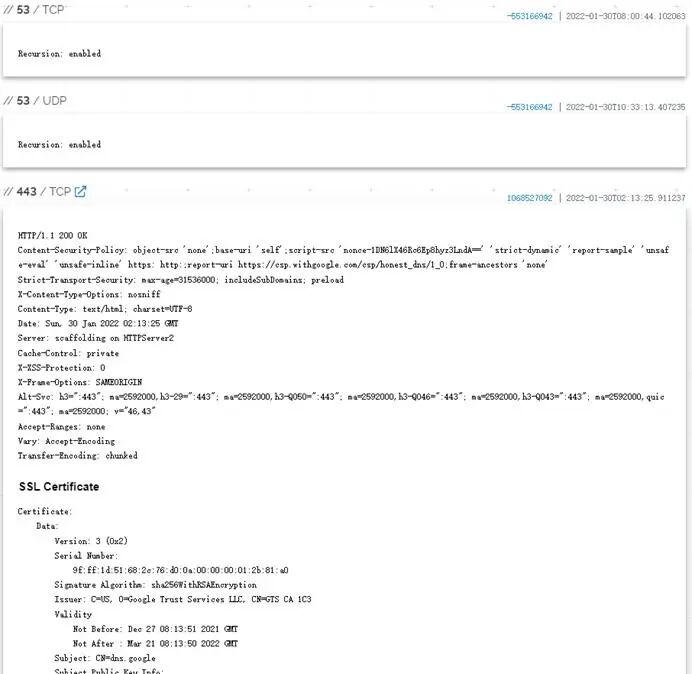
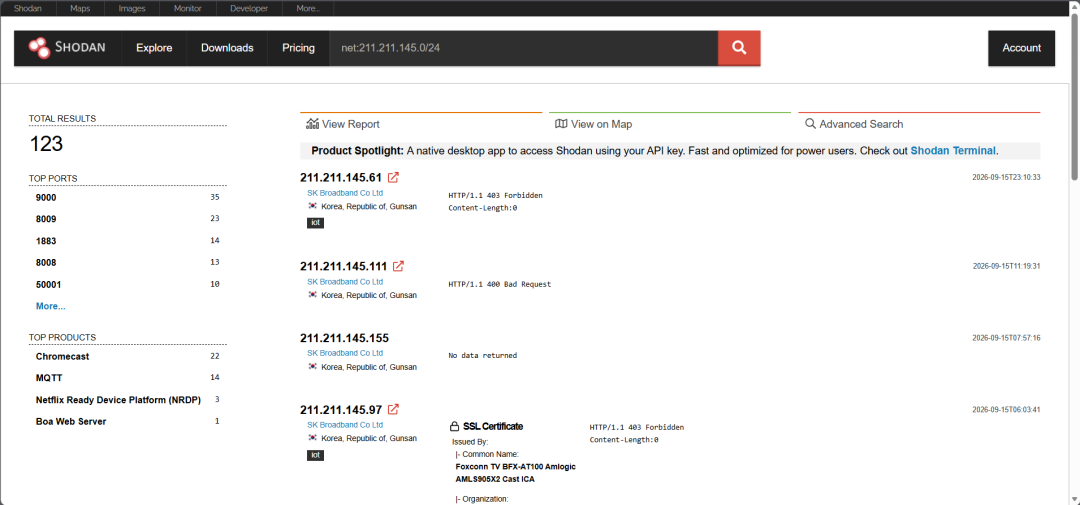
四,除了支持单个ip搜索外,shodan也支持整个网段的搜索,在搜索框中键入:
net:211.211.145.0/24
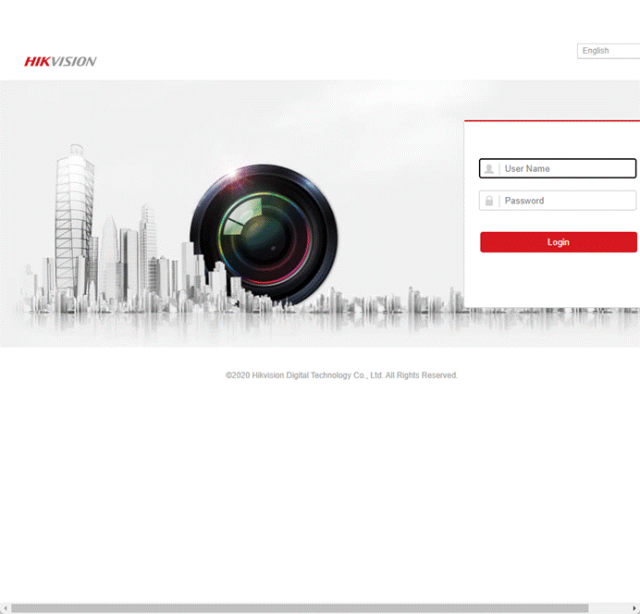
部分开放了80端口的服务器也支持直接访问:
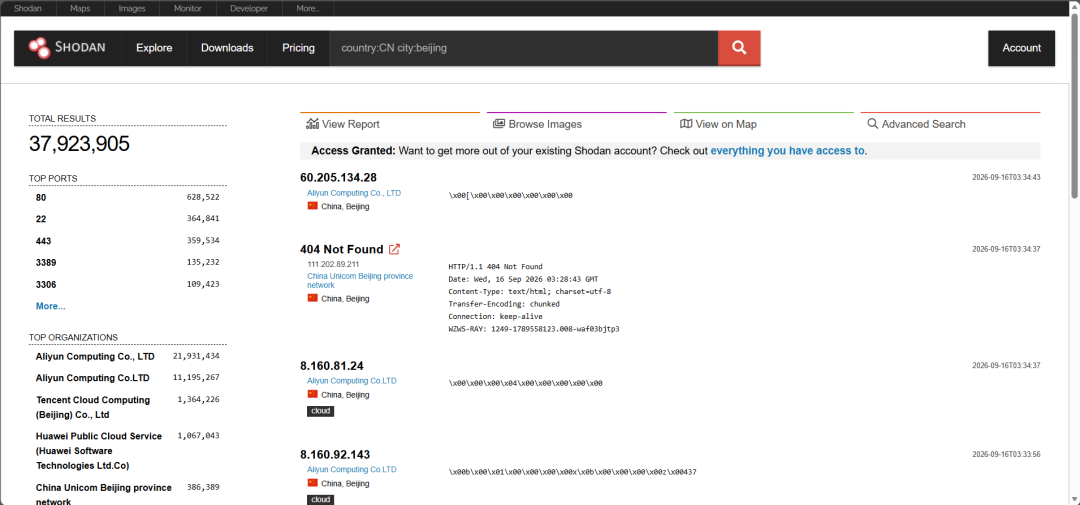
五,shodan同时提供地理位置查询,在搜索框键入:
country:CN city:beijing
那么将会返回整个北京地区可以被搜索到的互联网设备:
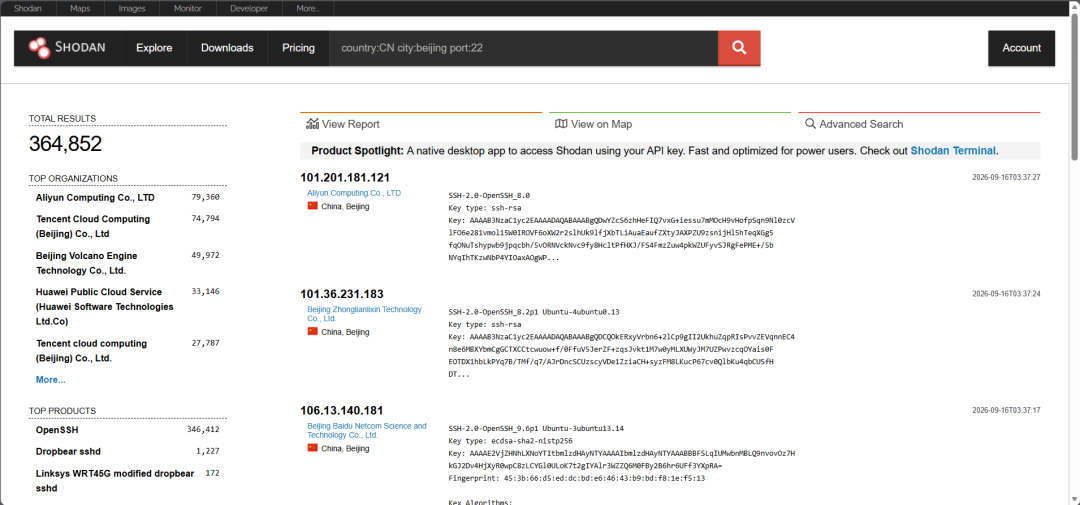
六,继续在搜索框当中添加:
port:22
shodan将会筛选结果,返回其中开放端口为22的结果。
七,过滤结果:
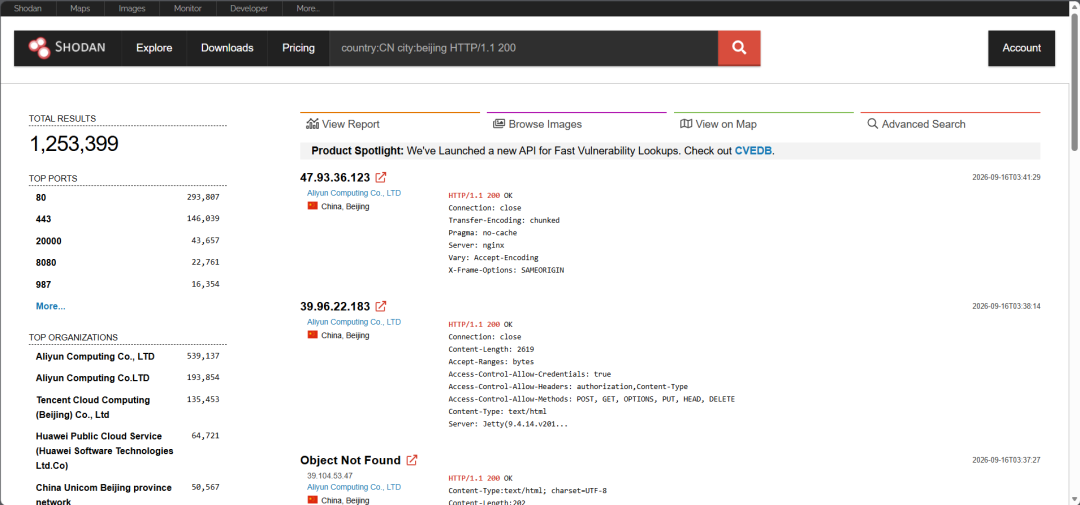
由于返回的结果众多,因此我们需要进一步筛选有用的结果,很多结果都是Http服务错误状态的返回,需要将这部分的结果去除。
HTTP/1.1 200
这样就能保证搜到的结果都是200的返回状态码。
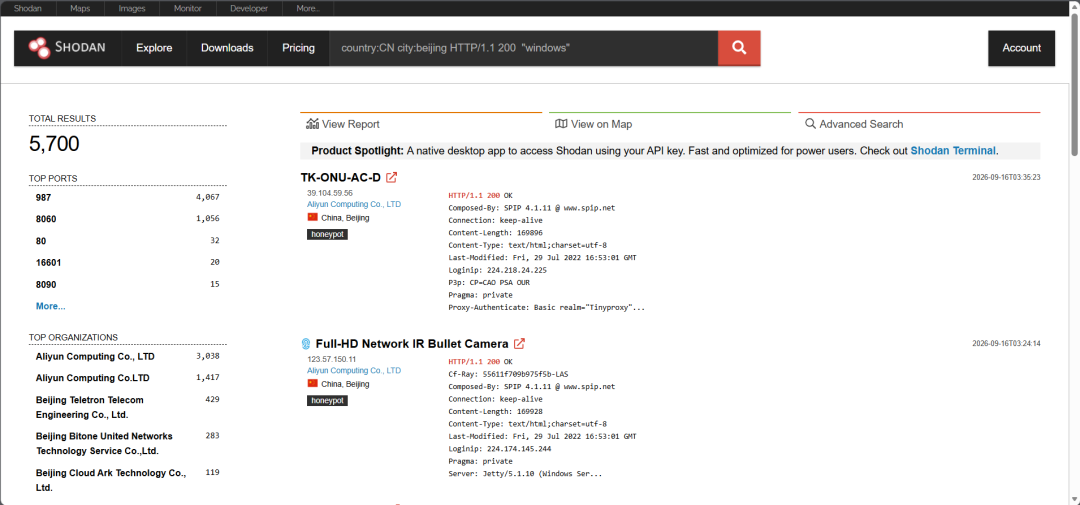
八,指定系统:
"windows"
将该语句填入搜索框中,将会筛选出所有操作系统为Windows的设备。
九,指定域名:
hostname:baidu.com
将该语句填入搜索框中,将会筛选出所有域名为指定域名的设备。
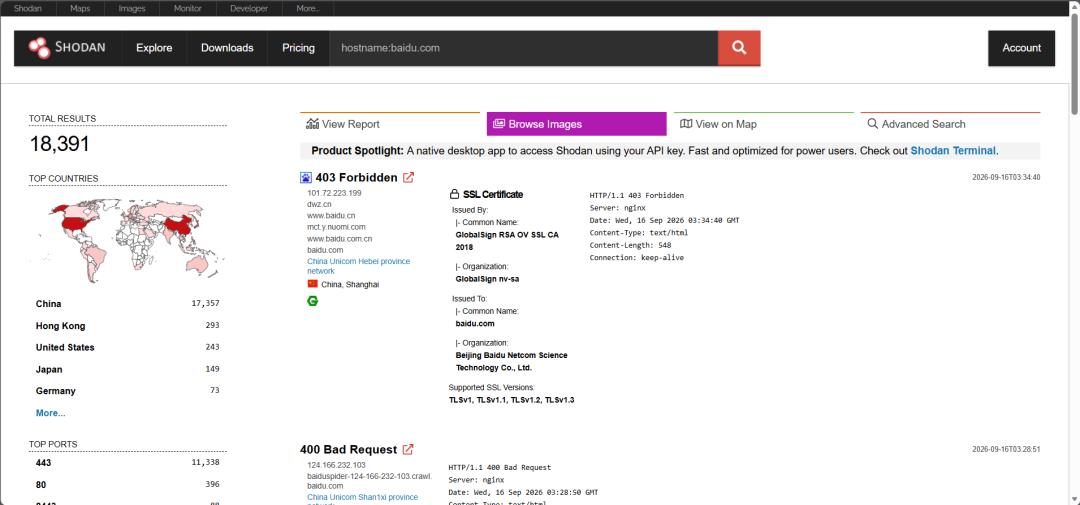
在实际搜索使用shodan的时候,并不需要严格按照语法进行。
十一,搜索cppu.edu.cn
hostname:cppu.edu.cn
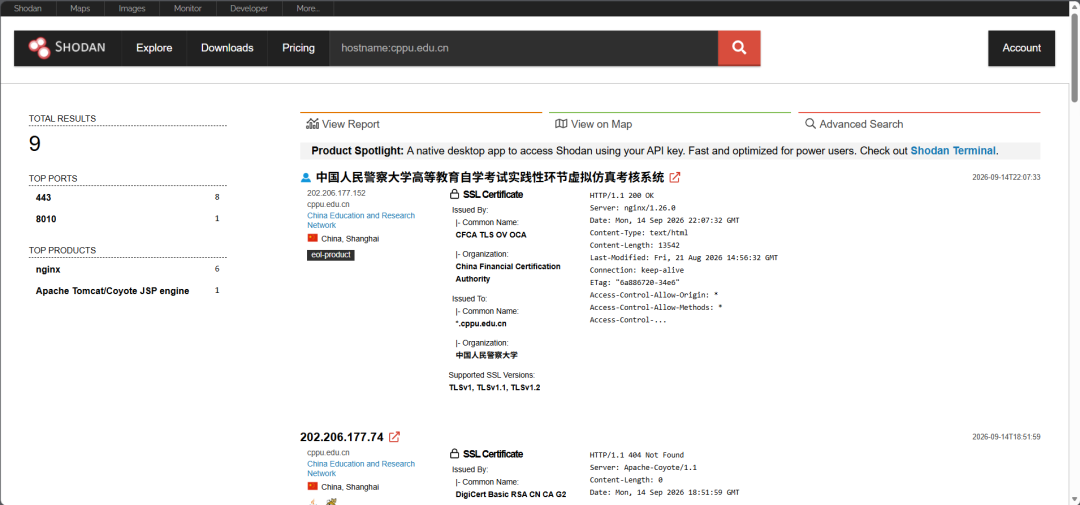
六 资产与旁站测绘——FOFA
相关知识
FOFA是白帽汇推出的一款用于网络空间资产搜索的引擎,访问地址为【[11]https://fofa.info/】[12],它能实现漏洞影响范围分析、应用分布统计等,能帮助用户快速进行网络资产匹配,FOFA也有简单的查询语法。
FOFA 的常用查询语法包括:title(网页标题)、header(HTTP 响应头)、body(页面正文)、fid(网站指纹)、domain(域名)、ip(IP 地址)、js_name(JS 文件名)、js_md5(JS 文件哈希)等,多种语法可组合使用,实现精细化的资产检索。
步骤
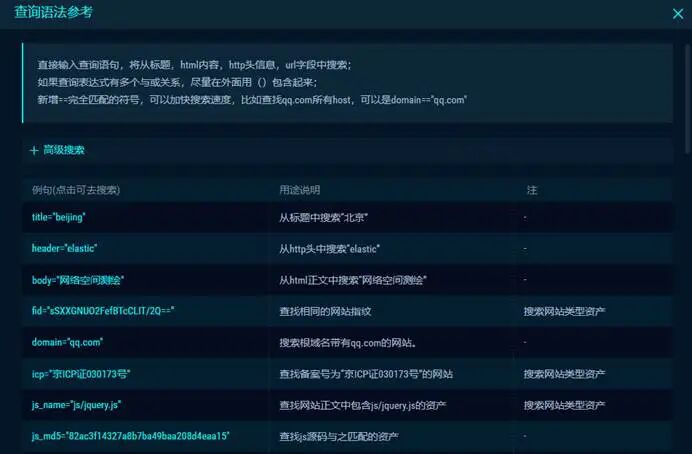
通过domain="baidu.com" 搜索baidu.com的子域名。
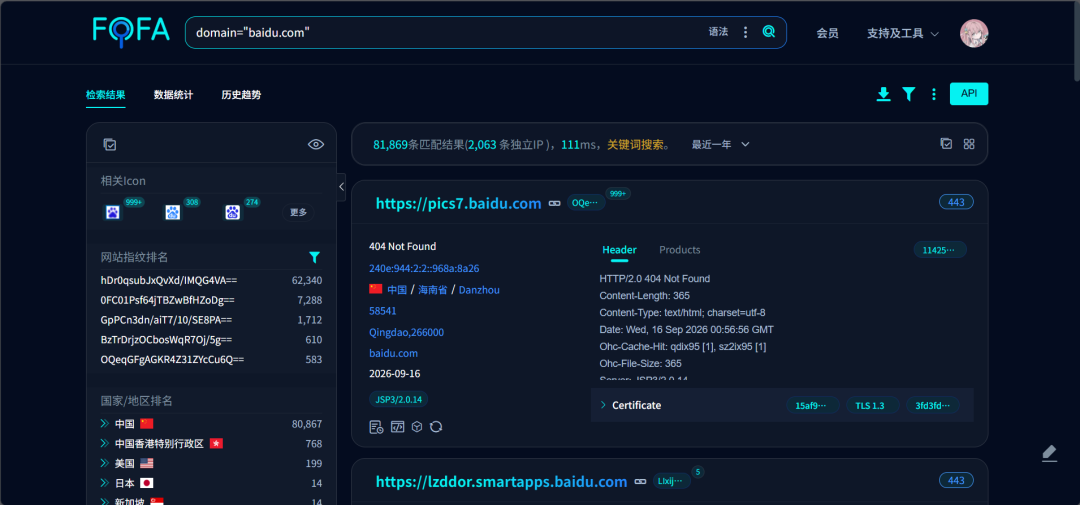
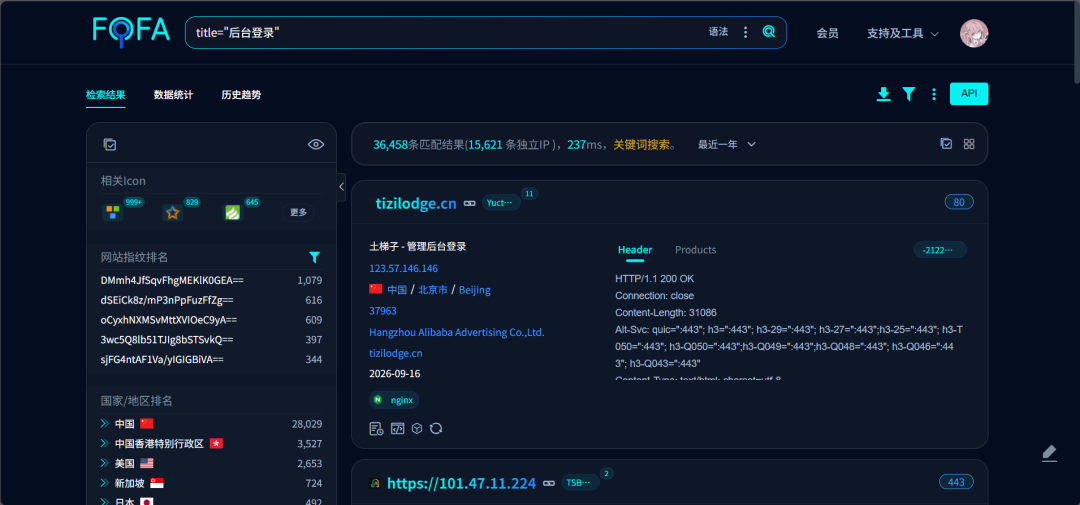
通过title="后台登录"寻找网站后台。
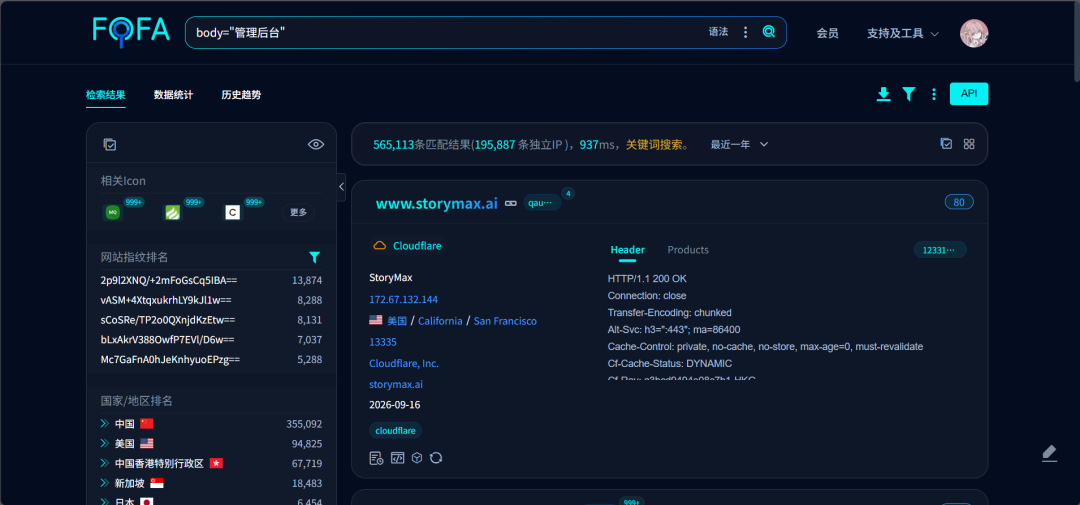
通过 body="管理后台",寻找管理后台。
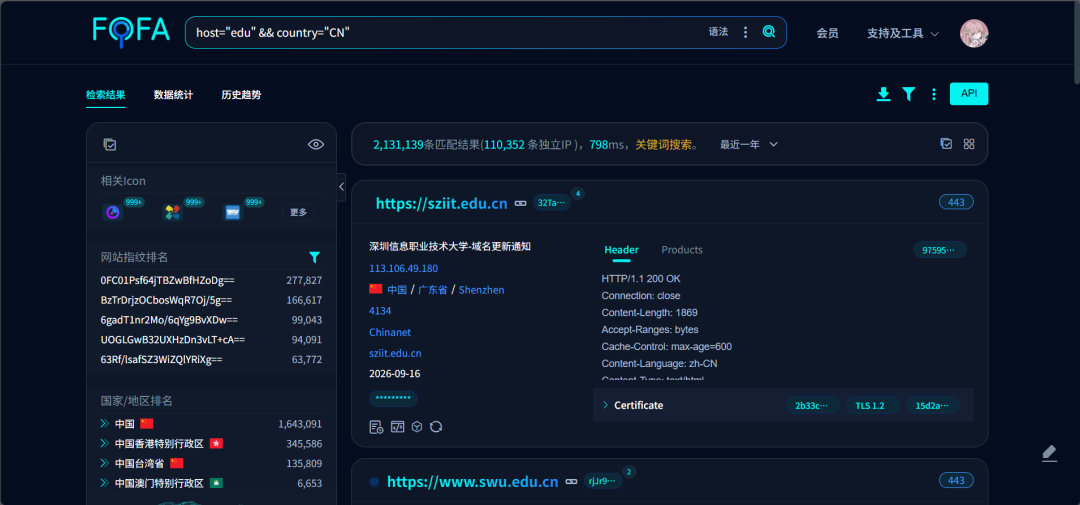
通过host="edu" && country="CN"搜索域名中带有"edu"关键词的网站。
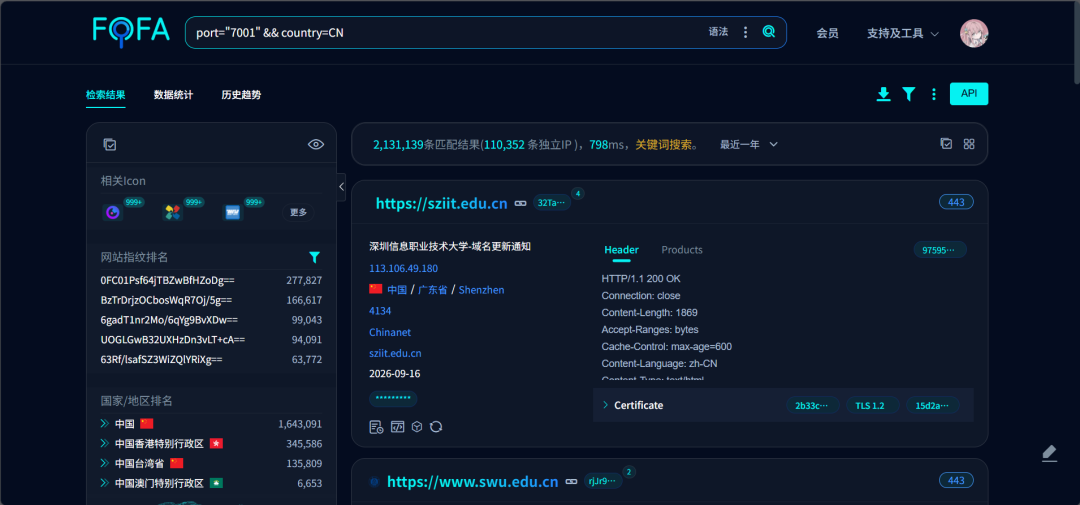
通过port="7001" && country=CN搜索开放weblogic服务并且位于中国的IP。
当然,fofa语法的用法远远不止上面所介绍的。熟练运用fofa语法可以帮助我们快速有效的进行信息收集与外围的打点工作。
总结与思考
总结
这部分内容是学习信息收集相关工具的使用,主要内容包括:
l 使用搜索引擎语法(Google Hacking)挖掘公开信息。
l 使用 Whois 与备案渠道获取域名注册信息,使用 netcraft 获取网站技术信息。
l 使用子域名查询、nslookup 和 dig 完成 DNS 信息收集,实现域名到 IP 的映射。
l 使用 shodan 和 FOFA 进行网络空间测绘,从 IP、端口、服务、资产维度绘制目标画像。
思考
l 除了书本上介绍的Whois信息查询,ip、域名与子域名等信息收集,你还知道哪些被动信息收集的方向? 除了基础项,还有以下维度值得关注:
证书透明度日志分析:通过查询 crt.sh等证书透明度(Certificate Transparency, CT)日志,可以发现大量未公开的子域名和关联资产。社交媒体与人员情报:从领英、微博、GitHub等平台,可以收集员工信息、技术栈、内部项目名甚至泄露的凭据。使用 social_mapper等工具,甚至能通过人脸识别进行人物侧写。历史快照与归档:利用 Wayback Machine 等工具查看网站的历史版本,可能发现已删除的敏感页面、旧版接口或测试环境入口。 代码仓库与泄露数据:监控 GitHub、GitLab 等平台,搜索目标组织相关的代码、API密钥、内部文档。同时,可利用 Intelligence X、Pastebin 等平台监测数据泄露事件。 商业与网络空间资产测绘:除了 Shodan、FOFA,还有 Censys、ZoomEye、Quake 等平台,它们从不同维度(如TLS证书、Web应用层)持续扫描互联网,是发现暴露资产的核心工具。 DNS与路由信息:通过 SecurityTrails、DNSDB等被动DNS数据库,可以查询历史DNS解析记录、IP与域名的关联关系。无线与物理情报:通过 WiGLE等平台查看公开的Wi-Fi热点地图,或结合社交媒体照片中的地理位置信息,可以进行物理位置的情报收集。自动化框架与工具集:使用 OWASP Amass、theHarvester、Recon-ng、SpiderFoot 等框架,可以自动化地整合多个数据源进行信息收集。 l shodan 与 FOFA 在数据来源和查询语法上有何异同?各适合什么场景?
| Shodan | FOFA | |
|---|---|---|
| 数据来源 | ||
| 查询语法 | port:22 country:"CN"。 | &&、` |
| 数据侧重 | 硬件设备识别能力强 | Web应用层资产丰富 |
| 数据时效 | ||
| 典型场景 | 全球暴露面监控、工控设备发现、漏洞预警订阅 | 企业数字资产梳理、Web类资产定位、中文环境下的漏洞影响面分析 |
l 利用搜索引擎语法搜集到敏感文件时,测试人员应遵守哪些法律与伦理边界?
技术本身合法,但行为有边界:使用搜索引擎语法进行搜索这一行为本身通常是合法的。然而,后续行为是判定是否违法的关键。仅仅发现一个公开暴露的文件,通常被视为被动侦察,是合法的。但是,未经授权,擅自访问、下载、复制或利用这些文件中包含的数据,则可能构成违法行为,会面临严重的法律后果。 必须遵守的合规红线: • 授权是前提:所有测试行为必须获得目标组织的明确书面授权。严禁对未授权的目标进行任何形式的探测。 • 遵守服务条款:进行搜索时,必须遵守谷歌等搜索引擎的服务条款。使用自动化工具进行大规模查询,可能违反其条款并导致IP被封禁。 • 保护个人隐私:即使是公开的个人数据,也可能受到GDPR等隐私法规的保护。将多个无关的公开数据点聚合,形成详细的个人画像,可能跨越法律和伦理红线。 • 遵循最小必要原则:在授权的渗透测试中,一旦证明漏洞存在,就应立即停止。例如,通过Google Dorking发现一个敏感文件后,仅能记录其存在作为证明,严禁下载或读取其内容,更不能执行删除或修改操作。 总结来说,被动信息收集的核心在于隐蔽性和不交互。Shodan和FOFA是这一过程中的利器,但使用时需明确其数据源和语法差异。最重要的是,任何安全测试都必须在明确的法律授权和伦理框架内进行,技术的合法性不能成为越界行为的借口。