作者信息:本文一作孟维康是哈尔滨工业大学(深圳)与鹏城实验室联合培养的博士生,本科毕业于哈尔滨工业大学,主要研究方向是大规模基础模型的高效训练和推理算法。通讯作者张正教授是哈尔滨工业大学(深圳)长聘教授、博士生导师,长期从事高效能多模态机器学习研究。
继 ICLR 2025 的 PolaFormer 之后,哈工大(深圳)与鹏城实验室合作的扩展版本 PolaFormer++ 近日被 IEEE TPAMI 正式接收。新版本在理论框架、特征映射设计和实验覆盖面上全面升级:首次给出判定特征映射是否具备「降熵尖锐性」的理论判据,并提出极性感知的通道级尖锐(PaCS)特征映射,在六大类视觉核心任务上全面验证了线性注意力的潜力。
论文题目:PolaFormer++: Polarity-Aware Linear Attention with Channel-wise Spikiness 作者:Weikang Meng, Yadan Luo, Liangyu Huo, Yingjian Li, Yaowei Wang, Zheng Zhang, Heng Tao Shen 单位:哈尔滨工业大学(深圳),鹏城实验室,昆士兰大学,同济大学 代码开源:https://github.com/ZacharyMeng/PolaFormerPP 论文链接:https://ieeexplore.ieee.org/document/11657470 会议版论文(ICLR 2025):https://arxiv.org/abs/2501.15061
一、引入:线性注意力的两大「先天不足」
Transformer 的核心——Softmax 自注意力,复杂度是序列长度的平方 O(N2d)。处理长视频、高分辨率图像时,计算和显存开销急剧上升,严重限制了实际部署。
线性注意力用核化特征映射 ϕ(⋅) 替换 Softmax,把计算改写为 ϕ(Q)(ϕ(K)⊤V),借助矩阵乘法结合律将复杂度降为线性的 O(Nd′²)。但效率的提升是以表达能力为代价的,差距主要来自两方面:
1. 负值丢失。为保证注意力权重非负,现有方法(如基于 ReLU、1+ELU 的特征映射)不得不把 query 和 key 中的负值全部置零。将 q、k 按正负部分解后可以看到,内积实际上包含四项:
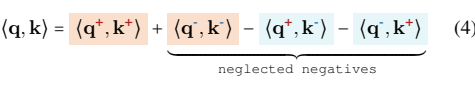
前两项是同号维度间的交互,后两项是异号维度间的交互。基于 ReLU 的映射直接把负成分抹掉,后两项(neglected negatives)完全丢失 —— 模型再也无法完整地重建原始的 q・k 相似度。
2. 注意力分布信息熵过高。没有了 Softmax 的指数缩放,线性注意力的权重分布趋于均匀,熵更高、不「尖锐」。模型难以区分强弱 q-k 对,对关键 token 的关注力被稀释。此前的补救方案(如 FLatten Transformer 的固定幂函数)对所有通道施加统一的尖锐程度,忽略了不同通道本就需要不同程度的尖锐化这一事实。
二、PolaFormer 回顾:极性感知线性注意力
PolaFormer(ICLR 2025)的核心思想是极性分解:把 q 和 k 逐元素拆成正部与负部(q=q+−q−,k=k+−k−),让正负成分平等地参与相似度计算。同号交互与异号交互分别在同号流(Same-polar Flow)和异号流(Opposite-polar Flow)中独立处理;value 向量沿通道维一分为二,分别承载两路的响应;最后用两个可学习的极性门控矩阵 Gs、Go 对两路输出做 Hadamard 加权,以可学习的方式近似「减法」操作、补偿松弛减法带来的影响,同时保证注意力权重非负。
三、PolaFormer++:通道级尖锐度的全面进化
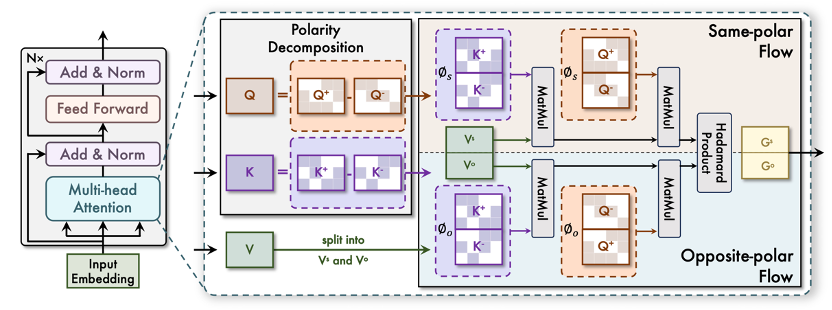
图 1:PolaFormer++ 整体框架。query-key 对按极性被显式拆分为同号流与异号流,两路输出分别由可学习符号感知矩阵 Gs、Go 调控;极性感知的通道级尖锐特征映射(PaCS)ϕs、ϕo 分别作用于两路,在保持尖锐性的同时区分不同通道对不同极性流的贡献。
3.1 PaCS:给每个通道配一个可学习的「温度」
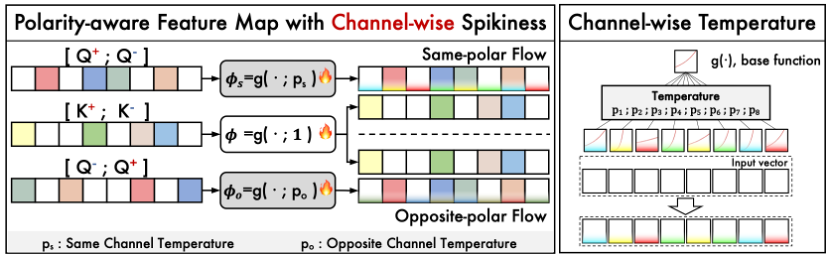
图 2:PaCS 示意。左:极性分解后的向量由不同的极性流驱动,正负成分获得独立的尖锐化映射;右:基函数与逐通道温度参数组合,构建通道级差异化的特征映射,使输入向量呈现多尺度、通道级的尖锐性。
具体设计上,作者以指数函数为基函数,为每个通道引入一个可学习的温度系数 p(由 sigmoid 归一化):
ϕ(x;p)=(exp(p1x1),…,exp(pdxd))−1
同号流与异号流各配一套温度向量 ps 和 po,分别得到特征映射 gs(⋅;ps) 与 go(⋅;po)
这样一来,每个通道、每条极性流都有自己专属的「尖锐度旋钮」,模型可以自适应地放大判别性强的响应、压平次要响应,把强弱注意力信号有效分离。
3.2 网络真的学到了「逐通道差异化」吗?
作者将训练后同号流两个温度参数(s1,s2)按通道画成散点图。可以看到,点云大范围弥散、显著偏离 y = x 对角线——说明网络为不同通道学到了高度独立的尖锐化行为,而不是趋同于一个固定幂次。
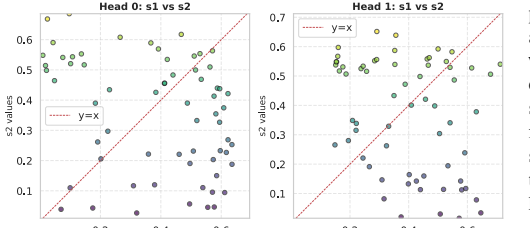
图 3:每个点代表一个特征通道的一对温度参数(s1,s2)(s1,s2)。显著偏离 y=x 对角线表明网络为每种极性学习到了高度独立的分布。
类似的,对极性门控矩阵 Gs 与 Go 在多个层上做 PCA 可视化,两类矩阵在特征空间中形成明显分离的簇,证实可学习混合策略确实捕捉到了同号与异号值之间互补的关系:
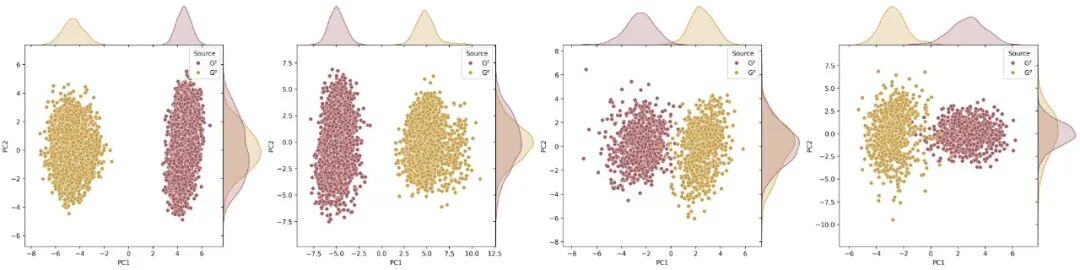
图 4:不同层中 Gs(红)与 Go(黄)的 PCA 可视化。两类门控矩阵分布明显分离,说明二者学到了互补的极性调控模式。
四、实验:六大视觉核心任务
PolaFormer++ 构建了 b0–b5 共 6 个规格的层级式视觉骨干家族(7M–114M 参数),并在六大类任务上做了系统验证。
4.1 ImageNet-1K 图像分类
PolaFormer++ 在各规格上均取得同级别最优或极具竞争力的精度:
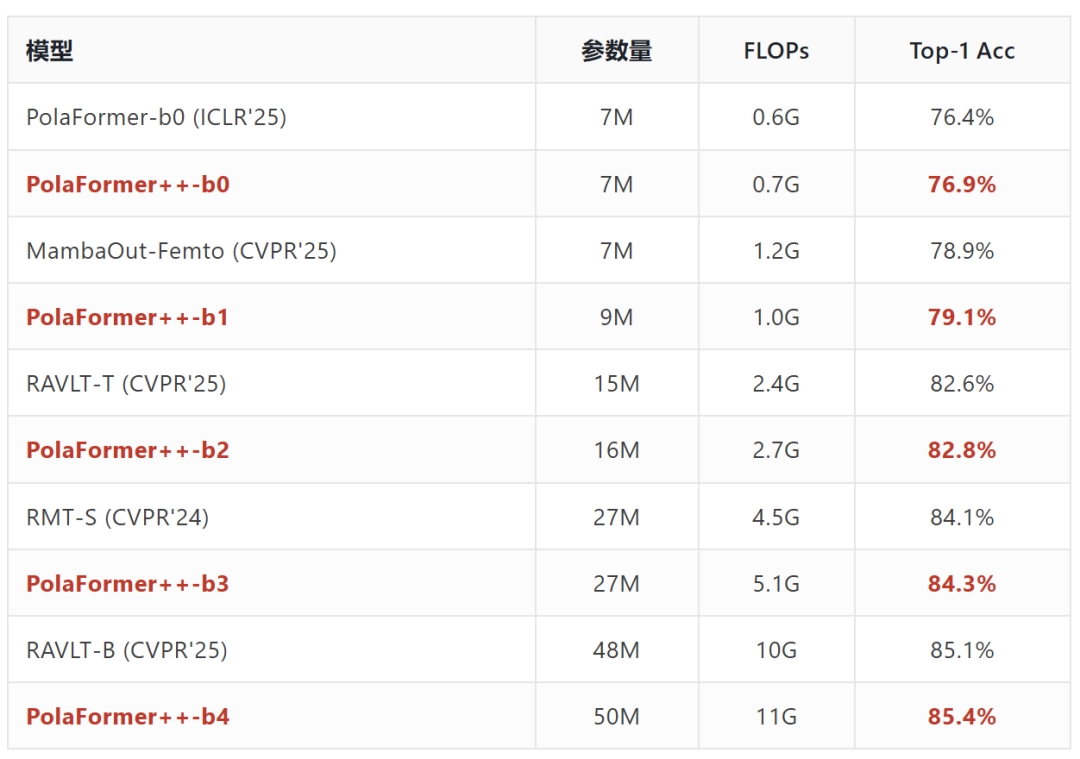
精度 - 算力曲线上,PolaFormer++(红色实线)整体位于最上方,在各个计算档位都压过近三年的高效模型:
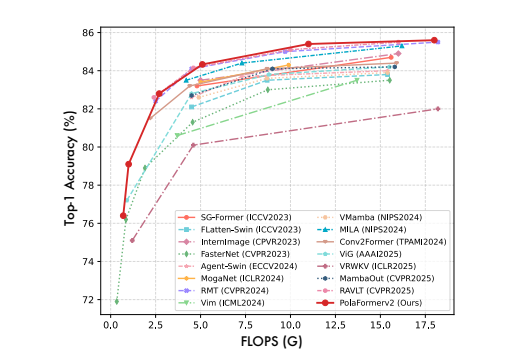
图 6:ImageNet-1K 上 Top-1 精度 vs. FLOPs 曲线,PolaFormer++(红色)在各档位全面领先。
4.2 效率:长序列下最高 5.25× 提速
在 4K–200K 序列长度上实测吞吐与峰值显存:普通 Softmax 注意力(Vanilla-Torch)在 65K 之后直接 OOM;Flash Attention 虽不爆显存,但速度被 PolaFormer++ 越甩越远 ——在 200K 序列长度下提速达 5.25×,且显存占用始终保持最低。
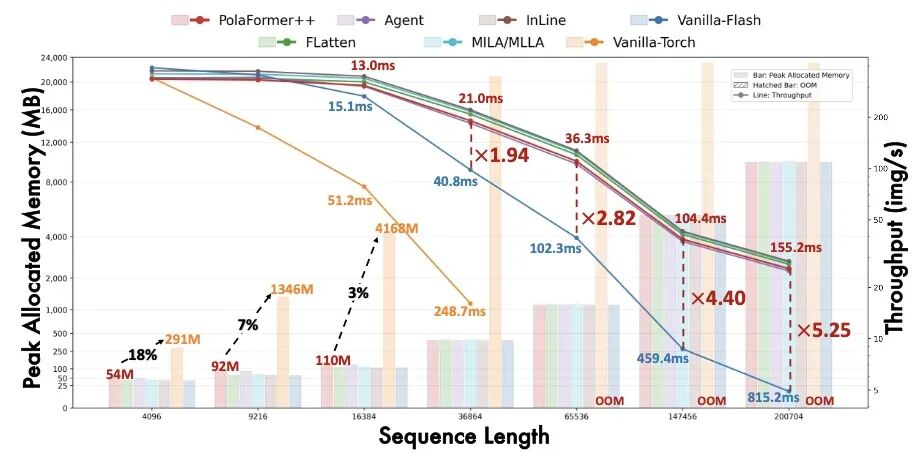
图 7:吞吐(折线)与峰值显存(柱状)随序列长度的变化。PolaFormer++ 在长序列下显著优于 Flash Attention,最高提速 5.25×。
4.3 COCO 目标检测与实例分割
以 RetinaNet、Mask R-CNN(1× 与 3× schedule)为框架:
RetinaNet 1×:PolaFormer++-b2 达 46.0 APb,超过 RMT-T(45.1)与 RAVLT-T(44.1);b3 达 47.3 APb; Mask R-CNN 1×:b3 达 49.7 APb / 44.6 APm,以更少参数量超过 InternImage-S(69M,47.8 / 43.3);b4 达 51.5 / 45.9,超过 RMT-B(73M,51.1 / 45.5); Mask R-CNN 3×:b4 达 52.9 APb / 46.2 APm,超过 RMT-B(52.2 / 46.1)与 VMamba-S 等对手; 最大规格 b5(114M,522G)在 Mask R-CNN 1× 下达 51.9 APb / 46.1 APm,算力显著低于同精度模型。
4.4 ADE20K / Cityscapes 语义分割
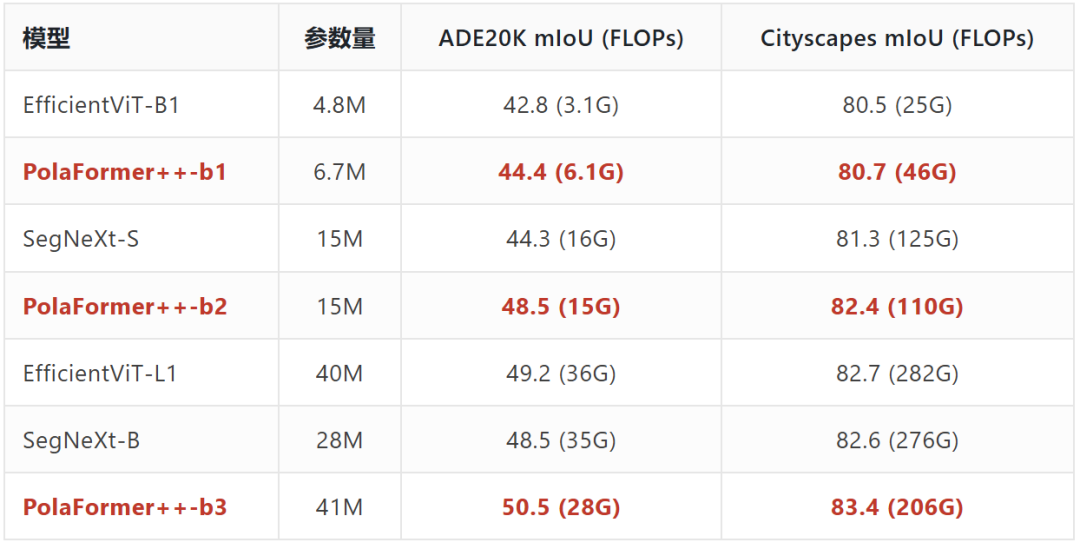
PolaFormer++-b3 在 ADE20K 上以 28G FLOPs 达到 50.5% mIoU,分别比 EfficientViT-L1 和 SegNeXt-B 高 1.3% 和 2.0%,且算力显著更低;Cityscapes 上 83.4% mIoU 同样领先。可视化结果中,PolaFormer++ 对行人、人行道、车辆的边界刻画更精细,复杂街景下也能完整分割远处人群:
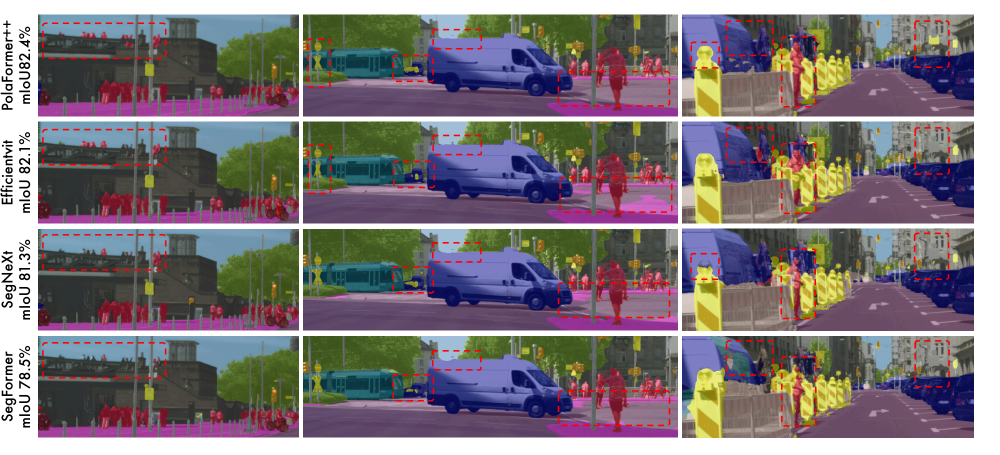
图 8:Cityscapes 语义分割可视化对比。红框标出关键差异区域,PolaFormer++(第一行)边界更细、目标区域更完整。
4.5 扩散生成(PolaDiT)
将 DiT 中的注意力替换为 PolaFormer++ 得到 PolaDiT,在 ImageNet-1K 类条件生成上:
DiT-S/2 规模:PolaDiT 取得最优 FID 58.30 / IS 25.29,优于 DiG(62.06)、MHLA(59.80)等近期线性注意力变体; DiT-B/2 规模:FID 36.00 / IS 41.56,继续保持线性注意力变体中的最优成绩,展现出优秀的可扩展性。
4.6 3D 新视角合成(Pola-GNT)
在 GNT 框架下替换点积注意力,LLFF 数据集 8 个场景平均:PSNR 从 27.25 dB 提升至 27.34 dB,LPIPS 从 0.1019 降至 0.1009,SSIM 从 0.8868 提升至 0.8885,三项指标全面改善,证明其在 3D 空间推理与几何建模中的适用性。
4.7 轻量级图像超分
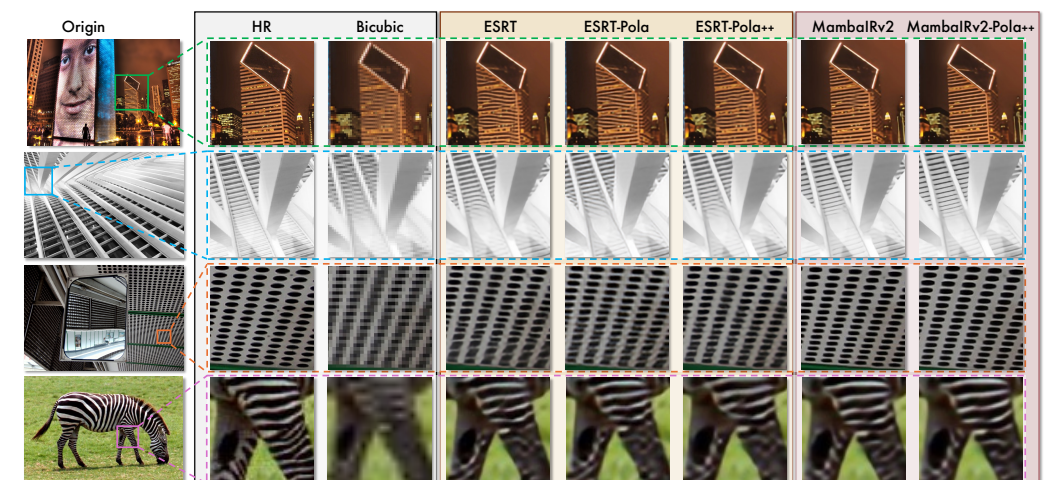
将 PolaFormer++ 接入 ESRT 与 MambaIRv2:
精度:MambaIRv2-Pola++ 在全部 5 个 benchmark 上超过此前最优的 ESC(如 ×4 下 Set5 32.59 dB / Manga109 31.38 dB); 效率:Urban100 ×3 下 ESRT-Pola++ 延迟仅 85.7ms,相比 ESRT(327.4ms)降低 73.8%,显存节省 90.0%;Manga109 上显存节省高达 92.5%。MambaIRv2 换成 Softmax 版本后在 Urban100、Manga109 等大分辨率测试集上直接 OOM,在小分辨率集上延迟也飙升近 20 倍(Set5:1504.8ms vs 78.6ms),而 Pola++ 版本几乎不增加开销。
4.8 消融与稳定性
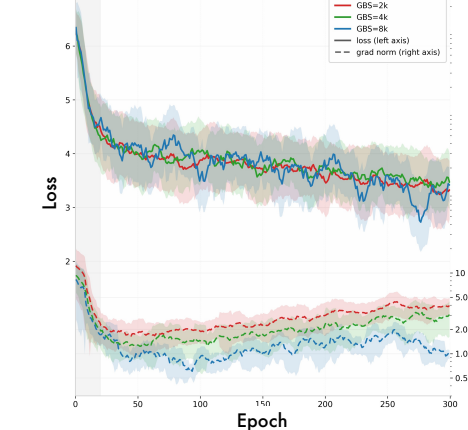
逐模块消融(ImageNet-1K,b0):极性机制基线 76.3%,加入门控矩阵 Gs/Go、可学习尖锐化、PaCS 等组件后逐步提升,完整模型达 76.9%; 与线性注意力同台对比(约 29M 参数、4.5G 量级 FLOPs 的统一设置):PolaFormer++ 以 82.8% 超过 Efficient Attn(81.0)、FLatten Attn(82.1)、Agent Attn(82.6)、InLine Attn(82.4)、LinDiff(82.3)等所有基线,且保持线性复杂度; 训练稳定性:BF16 混合精度、全局 batch 2048/4096/8192 三档设置下训练 300 epoch,loss 与梯度范数全程稳定,无爆炸、无 NaN、无发散。
五、结语
PolaFormer++ 从两个根本性问题出发 ——负值信息丢失与注意力分布不够尖锐—— 给出了统一且有理论支撑的解法:
极性感知:极性分解 + 双流交互 + 可学习门控矩阵,让 q、k 中的每个元素都平等参与注意力计算,完整重建相似度信息; 通道级尖锐度:PaCS 特征映射用两组可学习温度向量,为每个通道、每条极性流自适应调节尖锐程度; 通用理论判据:基于 Schur - 凹性首次给出判定特征映射是否具备降熵性质的严格标准,将 PolaFormer 的特例证明推广为通用框架。
从分类、检测、分割,到超分、扩散生成、3D 合成,PolaFormer++ 在六大类任务上实现了精度与效率的更优平衡,为视觉 Transformer 中的线性注意力建立了坚实的理论与实践基础。代码已开源,欢迎试用与拓展!
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com